> For the complete documentation index, see [llms.txt](https://genos-docs.gitbook.io/default/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://genos-docs.gitbook.io/default/v1.9.3/basic-tutorials/guides/llm/model-serving-ha.md).
# 모델 서빙 실행 확장(HA)
## 개요
실행 확장(HA)은 모델 서빙 리비전 하나를 여러 인스턴스로 늘려 요청을 나눠 처리하는 기능입니다. 유지할 개수를 직접 지정할 수도 있고, 부하에 따라 자동으로 늘고 줄도록 맡길 수도 있습니다.
**서빙 → 모델 서빙 → (서빙 선택) → 리비전 상세 → 기본 정보**의 "실행 확장 (HA)" 영역에서 **HA 수정**을 눌러 설정합니다. 설정은 리비전마다 따로 관리되며, 배포 중인 리비전은 저장 시 즉시 적용(`저장 시 즉시 적용`)되고 배포 중이 아닌 리비전은 다음 배포 때 적용(`다음 배포 시 적용`)됩니다.
인스턴스가 늘어나면 **인스턴스마다 GPU를 추가로 점유**합니다. 이 문서는 그 비용을 감안해 어떤 설정을 고를지 판단하는 데 초점을 둡니다.
리비전 상세 화면 하단의 실행 확장 (HA) 영역
## 주요 개념
| 개념 | 설명 |
| -------------- | ----------------------------------------------------------------------------------------------------------- |
| 확장 방식 | 개수를 어떻게 정할지 고르는 값입니다. **고정**은 지정한 개수를 그대로 유지하고, \*\*자동 (부하 기반)\*\*은 부하에 따라 최소\~최대 범위에서 조절합니다. |
| 확장 신호 | 자동 방식에서 무엇을 부하로 볼지 고르는 값입니다. **큐**(엔진 대기열) 또는 **CPU**(파드 CPU 사용률) 중 하나이며, 리비전이 쓰는 엔진에 따라 고를 수 있는 항목이 달라집니다. |
| 최소·최대 | 자동 방식의 조절 범위입니다. 최소는 부하가 없어도 항상 유지되고, 최대는 늘어날 수 있는 상한입니다. |
| 증설 기준 | 인스턴스 하나가 감당한다고 볼 양입니다. 현재 부하를 이 값으로 나눠 필요한 개수를 계산합니다. |
| 기동 기준 | 0개에서 1개로 띄우기 시작하는 기준입니다. |
| 증설 폭 · 축소 폭 | 한 번에 얼마나 늘리고 줄일지입니다. **단위 / 값 / 주기(초)** 세 칸으로 지정합니다. |
| 증설 동작 · 축소 동작 | 그 방향으로 자동 조절을 할지 정합니다. `Disabled`면 그 방향으로는 움직이지 않습니다. |
| 감시 주기 | 신호를 확인하는 간격입니다. |
| 지표 조회 실패 허용 횟수 | 신호를 읽지 못한 상태를 몇 번까지 참을지입니다. |
| 증설 지속 시간 | 부하가 이 시간만큼 계속됐을 때만 개수를 늘립니다. |
| 축소 대기 시간 | 부하가 내려간 뒤 이 시간을 기다린 다음 줄이기 시작합니다. |
## 설정하기
**HA 수정**을 눌러 편집 모드로 들어가 **사용**을 켜고, 확장 방식을 고른 뒤 저장합니다. 자동 방식이면 확장 신호와 최소·최대를, 고정 방식이면 **동시 실행 인스턴스 수**를 입력합니다. 저장 전에 확인 창이 한 번 표시됩니다.
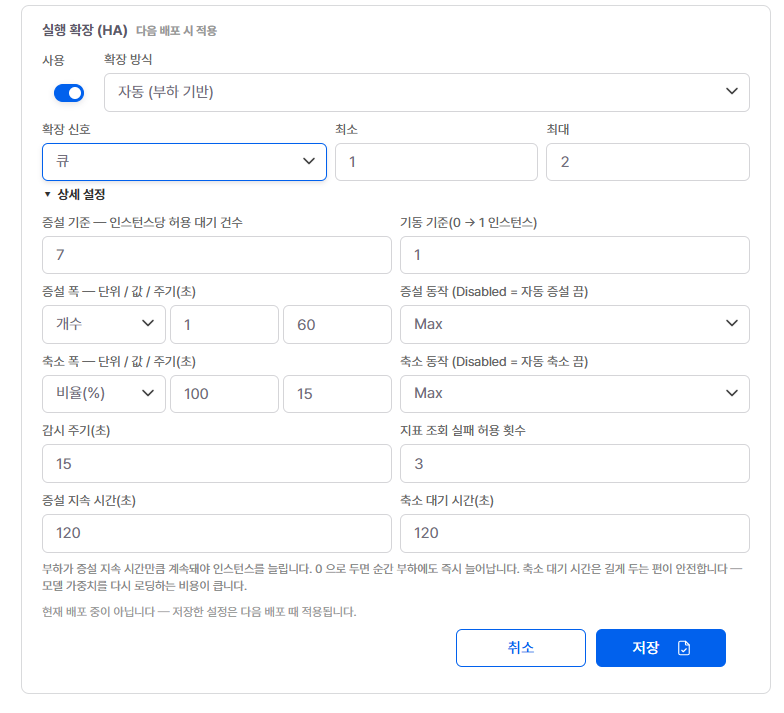
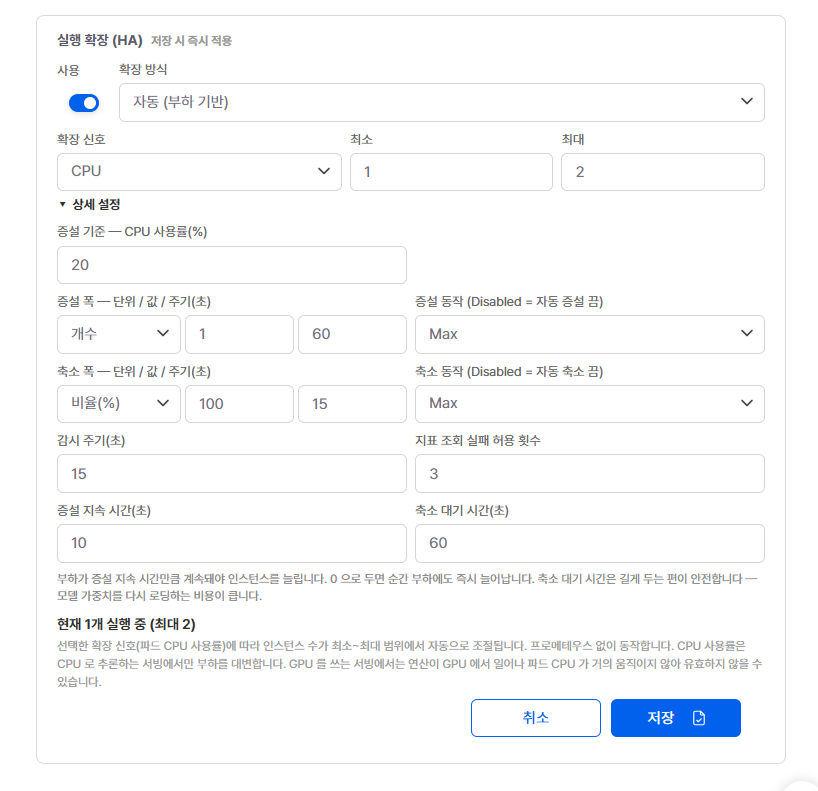
기본 화면에는 확장 신호와 최소·최대만 두고, 나머지 값은 **상세 설정**을 펼쳐야 보입니다. 값을 건드리지 않으면 기본값이 적용되므로 대부분은 펼치지 않아도 됩니다. 상세 설정은 자동 방식에서만 나타납니다 — 고정 방식은 개수를 계산하지 않으므로 이 값들이 쓰이지 않습니다.
상세 설정을 펼친 편집 화면 (큐 신호)
저장하면 설정 아래에 `현재 1개 실행 중 (최대 2)`처럼 실행 개수가 표시되고 15초마다 갱신됩니다.
고정 방식은 입력한 개수를 그대로 유지하며, 상세 설정 없이 **동시 실행 인스턴스 수** 한 칸만 입력합니다.
고정 방식 — 동시 실행 인스턴스 수
> **고정 방식에서 1개는 "사용 안 함"과 같습니다.** 1개로 저장하면 실행 확장이 꺼진 상태로 저장됩니다. 확장하려면 2개 이상을 지정하거나 자동 방식을 고르세요.
## 실행 확장을 켜고 끌 때
실행 확장을 켜면 저장 시점부터 인스턴스 수를 이 설정이 관리합니다. 리비전을 만들 때 지정한 복제본 수는 더 이상 적용되지 않으며, 인스턴스마다 GPU를 추가로 점유합니다.
실행 확장을 켤 때 확인 창
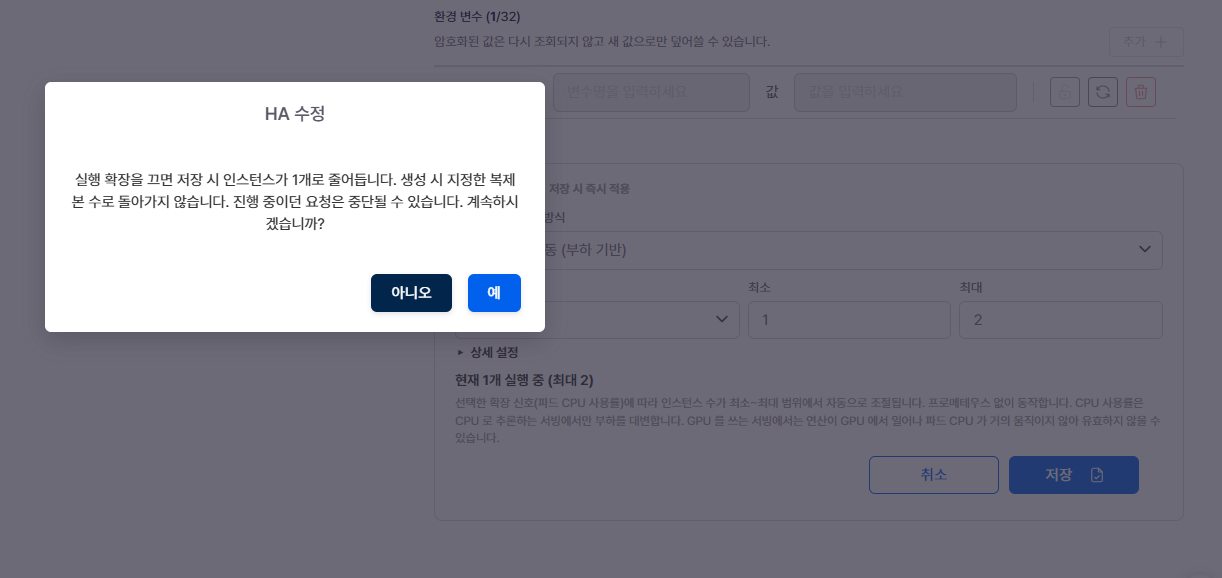
실행 확장을 끄면 인스턴스가 1개로 줄어듭니다. 만들 때 지정한 복제본 수로 돌아가지 않고, 진행 중이던 요청이 중단될 수 있습니다. 원래 개수를 유지하고 싶다면 끄는 대신 확장 방식을 **고정**으로 바꿔 그 수를 직접 입력하세요. 끄는 동작은 "1개로 돌린다"는 뜻에 가깝습니다.
실행 확장을 끌 때 확인 창
***
## 상세 설정 항목별 설명
자동 방식에서 쓰이는 값 전체입니다. **기본값은 코드 서빙과 다릅니다** — 모델 서빙은 인스턴스 하나를 새로 띄우는 비용이 훨씬 커서, 늘릴 때 신중하고 줄일 때는 오래 기다린 뒤 한 번에 정리하는 쪽으로 잡혀 있습니다.
모델 서빙 상세 설정 화면
| 항목 | 기본값 | 입력 범위 |
| ----------------------------- | ---------------- | -------------------- |
| 증설 기준 — 인스턴스당 허용 대기 건수 (큐 신호) | 5 | 1 이상 |
| 증설 기준 — CPU 사용률(%) (CPU 신호) | 70 | 1\~100 |
| 기동 기준(0 → 1 인스턴스) | 1 | 0 이상 |
| 증설 폭 — 단위 / 값 / 주기(초) | 개수 / 1 / 60 | 값 1 이상, 주기 1\~1800 |
| 증설 동작 | Max | Max · Min · Disabled |
| 축소 폭 — 단위 / 값 / 주기(초) | 비율(%) / 100 / 15 | 값 1 이상, 주기 1\~1800 |
| 축소 동작 | Max | Max · Min · Disabled |
| 감시 주기(초) | 15 | 1 이상 |
| 지표 조회 실패 허용 횟수 | 3 | 1 이상 |
| 증설 지속 시간(초) | 120 | 0\~3600 |
| 축소 대기 시간(초) | 600 | 0\~3600 |
| 최소 | 1 | 1 이상 |
| 최대 | 4 | 1 \~ GPU 쿼터 상한 |
### 증설 기준
인스턴스 하나가 감당한다고 볼 양입니다. 화면에는 지금 고른 신호에 해당하는 한 칸만 나옵니다 — 큐 신호면 `인스턴스당 허용 대기 건수`, CPU 신호면 `CPU 사용률(%)`입니다.
**낮추면 더 빨리·많이 늘고**(응답은 빨라지지만 GPU를 더 씁니다) **높이면 더 늦게·적게 늡니다.** 기준을 넘어야 늘어나므로 부하가 기준과 같을 때는 증설하지 않습니다.
인스턴스 하나가 감당하는 양은 모델·인스턴스 타입마다 다르므로 이 값은 리비전별로 저장됩니다. 큐 신호에서 요청 하나가 무거워 인스턴스 하나가 두세 건밖에 감당하지 못한다면 기본값 5는 이미 밀린 뒤에 늘어나므로 2\~3으로 낮춥니다.
> 큐 신호에서 이 값을 낮추는 것은 **대기열이 실제로 형성되는 서빙에서만** 의미가 있습니다. 아래 [결정 가이드 3번](#3-큐-신호가-실제로-동작하는-조건--자동을-고르기-전-확인)에 해당해 신호가 0으로 유지되는 서빙이라면 기준을 1까지 낮춰도 증설되지 않습니다 — 나눌 값 자체가 0이기 때문입니다.
### 기동 기준(0 → 1 인스턴스)
인스턴스가 0개인 상태에서 1개를 띄우기 시작하는 조건입니다(기본 1). 이 값 이하의 부하는 "활동 없음"으로 봅니다. 대기가 한 건이라도 생기면 즉시 띄우려면 0으로 둡니다.
최소 개수를 1 이상으로 둔 경우에는 인스턴스가 0으로 내려가지 않으므로 이 값이 쓰이지 않습니다.
### 증설 폭 — 단위 / 값 / 주기(초)
한 번에 얼마나 늘릴지입니다. 세 칸을 함께 읽습니다.
* **단위** — `개수`는 그 주기에 N개를 늘립니다. `비율(%)`은 현재 인스턴스 수의 N%만큼 늘립니다.
* **값** — 늘릴 양입니다. 1 이상만 넣을 수 있습니다(0은 "늘리지 않음"이 아니라 잘못된 값입니다. 늘리지 않으려면 증설 동작을 Disabled로 둡니다).
* **주기(초)** — 이 폭이 적용되는 간격입니다.
기본값 `개수 / 1 / 60`은 **60초에 1개씩** 늘어난다는 뜻입니다. 1개에서 4개가 되려면 약 3분이 걸립니다. 폭발적인 트래픽을 더 빨리 흡수해야 한다면 값을 2\~3으로 올리거나 주기를 30초로 줄입니다. 다만 GPU를 그만큼 빨리 점유하므로 쿼터 여유를 먼저 확인해야 합니다.
### 증설 동작
자동 증설을 할지 정합니다. 기본 `Max`이며, **`Disabled`로 두면 자동으로 늘지 않습니다** — 사실상 최소 개수로 고정한 것과 같아집니다. `Min`은 여러 판정이 동시에 성립할 때 더 보수적인 쪽을 고르는 설정으로, 기본값을 바꿀 이유는 거의 없습니다.
### 축소 폭 — 단위 / 값 / 주기(초)
한 번에 얼마나 줄일지입니다. 읽는 방법은 증설 폭과 같습니다.
기본값 `비율(%) / 100 / 15`는 **제한을 두지 않는다는 뜻**입니다 — 15초 주기마다 현재 개수의 100%까지 줄일 수 있으므로, 축소 대기 시간이 지나면 한 번에 최소까지 내려갑니다. 이미 축소 대기 시간(기본 600초) 동안 부하가 낮음을 확인한 뒤이므로 기본값은 이렇게 잡혀 있습니다.
긴 생성 요청을 다루는 서빙이라면 단위를 `개수`, 값 1, 주기 60초로 바꾸는 편이 안전합니다. 60초에 하나씩 내려가므로 종료되는 인스턴스가 한꺼번에 생기지 않습니다.
### 축소 동작
자동 축소를 할지 정합니다. 기본 `Max`이며, **`Disabled`로 두면 부하가 내려가도 줄어들지 않습니다.** 이벤트 기간에 반복적인 축소·재증설을 막는 데 유용하지만, **끝난 뒤 반드시 Max로 되돌려야 합니다** — 그대로 두면 GPU를 계속 점유합니다.
### 감시 주기(초)
신호를 확인하는 간격입니다(기본 15초). 짧게 하면 판단이 조금 빨라지지만, 증설 지속 시간과 인스턴스 기동 시간이 훨씬 크기 때문에 체감되는 차이는 거의 없습니다. 반대로 길게 하면 부하 변화를 늦게 알아차립니다. **기본값을 바꿀 이유는 거의 없습니다.**
### 지표 조회 실패 허용 횟수
신호를 읽지 못한 상태를 몇 번까지 참을지입니다(기본 3). 프로메테우스가 잠깐 응답하지 않는 정도는 이 횟수 안에서 넘어갑니다. 연속으로 이 횟수를 넘기면 시스템은 **개수를 최소 개수로 유지**합니다. 부하를 알 수 없는 상태에서 임의로 늘리거나 줄이지 않기 위한 동작입니다.
부하가 분명히 높은데 개수가 최소에 붙어 움직이지 않는다면 이 상태를 의심하고 관리자에게 프로메테우스 상태를 확인하세요. 네트워크가 불안정한 사이트라면 5 정도로 올려 두는 편이 안정적입니다.
> 이 보호 동작은 **큐 신호에만** 적용됩니다. CPU 신호는 지표 경로가 달라, 신호를 읽지 못하면 판단을 멈추고 그때의 개수를 유지합니다.
### 증설 지속 시간(초) · 축소 대기 시간(초)
증설 지속 시간(기본 120초)은 부하가 이 시간만큼 계속됐을 때만 늘리도록 하는 값입니다. 0으로 두면 순간 부하에도 바로 늘립니다. 축소 대기 시간(기본 600초)은 부하가 내려간 뒤 얼마나 기다린 다음 줄일지입니다. 둘 다 0\~3600초입니다.
**축소 대기 시간을 짧게 두지 마세요.** 모델 서빙은 인스턴스를 새로 띄울 때 가중치를 다시 로딩하고 엔진을 다시 준비하므로 요청을 받기까지 수 분이 걸립니다. 축소 대기 시간이 이보다 짧으면 늘린 인스턴스가 실제로 일하기도 전에 줄이는 낭비가 반복됩니다. 같은 이유로 증설 지속 시간도 기본값을 그대로 두는 편을 권합니다 — 자세한 배경은 [콜드 스타트](#새-인스턴스는-바로-일하지-못합니다--콜드-스타트)를 참고하세요.
## 값을 비우거나 잘못 넣었을 때
상세 설정의 모든 칸은 **정수만** 받습니다. 소수·문자를 넣거나 범위를 벗어나면 **저장되지 않고** 그 칸 아래에 사유가 표시됩니다.
| 화면 문구 | 뜻 |
| ------------------------------- | ------------------------ |
| 정수만 입력할 수 있습니다 | 소수점·문자가 들어갔습니다 |
| N 이상 M 이하로 입력하세요 / N 이상으로 입력하세요 | 그 칸의 허용 범위를 벗어났습니다 |
| 최솟값보다 작을 수 없습니다 | 최대가 최소보다 작습니다 |
| 비워두면 기본값 N 사용 | 그 칸을 비운 채 저장하면 N으로 저장됩니다 |
**칸을 비우는 것은 오류가 아닙니다.** 비우고 저장하면 그 항목의 기본값으로 되돌아갑니다. 여러 값을 만졌다가 원래대로 돌리고 싶을 때 값을 기억하지 않아도 되도록 만든 동작입니다.
> v1.9.3부터 잘못된 값은 저장이 **거부**됩니다. 그전에는 범위를 벗어난 값을 시스템이 조용히 잘라서 저장했기 때문에 "저장은 성공했는데 값이 다르게 들어가는" 일이 있었습니다. 지금은 사유가 표시되고 저장이 멈추므로, 문구를 보고 값을 고친 뒤 다시 저장하면 됩니다.
또한 **보이지 않는 칸은 검증 대상이 아닙니다.** 확장 신호를 큐에서 CPU로 바꾸면 큐 관련 칸은 화면에서 사라지고, 그 칸에 남아 있던 값 때문에 저장이 막히지는 않습니다.
## 인스턴스 수가 어떻게 정해지는가
자동 방식에서는 **감시 주기마다**(기본 15초) 신호를 확인하고 그때마다 필요한 개수를 다시 계산합니다.
```
필요한 개수 = 올림( 지금 부하 ÷ 증설 기준 )
```
* 큐 신호 — 대기 건수 12건, 증설 기준 5 → 올림(12÷5) = **3개**
* CPU 신호 — 인스턴스 2개의 평균 사용률 90%, 증설 기준 70 → 올림(90×2÷70) = **3개**
계산된 값이 최소보다 작으면 최소가, 최대보다 크면 최대가 됩니다. 여기까지가 "필요하다고 본 개수"이고, 실제로 그 개수로 옮기기 전에 시간 조건을 한 번 더 통과합니다.
| 방향 | 판단 방법 | 결과 |
| ---- | -------------------------------------- | --------------------------- |
| 늘릴 때 | 증설 지속 시간 구간에서 계산된 값들 중 **가장 작은 값**을 채택 | 그 시간 내내 부하가 유지돼야 늘어남 |
| 줄일 때 | 축소 대기 시간 구간에서 계산된 값들 중 **가장 큰 값**을 채택 | 그 시간 안에 한 번이라도 부하가 튀면 줄지 않음 |
증설 지속 시간을 0으로 두어도 즉시는 아닙니다. 감시 주기가 15초라 실제로는 **15\~30초** 뒤에 반영됩니다.
## 늘어날 때와 줄어들 때는 속도가 다릅니다
시간 조건을 통과해 "옮기기로" 결정한 뒤에도, 한 번에 움직일 수 있는 폭은 증설 폭·축소 폭이 정합니다. 모델 서빙 기본값은 이렇게 동작합니다.
| | 기본 설정 | 실제 움직임 |
| -- | --------------- | ---------------------------------------- |
| 증설 | 개수 / 1 / 60초 | **60초에 1개씩** — 1개에서 4개가 되려면 약 3분 |
| 축소 | 비율 / 100% / 15초 | 제한이 사실상 없음 — 축소 대기 시간이 지나면 **한 번에 최소까지** |
즉 모델 서빙 기본값은 **천천히 늘고, 오래 기다린 뒤 한 번에 줄이는** 모양입니다. 늘릴 때 한 개씩 가는 이유는 인스턴스마다 GPU를 새로 점유하기 때문이고, 줄일 때 한 번에 가는 이유는 이미 축소 대기 시간 동안 부하가 낮음을 확인했기 때문입니다.
> 최대 개수는 "순간적으로 점유해도 되는 자원"으로 잡습니다. 평균 사용량이 아닙니다. 증설 폭을 키웠다면 그만큼 빨리 최대에 도달합니다.
## 새 인스턴스는 바로 일하지 못합니다 — 콜드 스타트
늘리기로 결정되고 파드가 떠도, 그 인스턴스가 요청을 받기까지는 시간이 걸립니다. **모델 서빙에서 증설 속도를 실제로 정하는 것은 설정이 아니라 이 기동 시간입니다.**
| 엔진 | 무엇을 기다리는가 |
| -------------------------------------------- | ----------------------------------------------------------- |
| **LLM 계열** (vLLM 기반 — LLM · 임베딩 · 리랭킹 · VLM) | 모델 가중치 로딩 + **엔진 컴파일**. 실측 6\~8분이 걸립니다. |
| **Triton** | 컴파일은 없지만 모델을 로드하는 동안 지연이 발생합니다. 모델 크기·구성에 따라 수십 초에서 수 분입니다. |
**현재 GenOS는 컴파일 결과를 인스턴스 사이에 공유하거나 미리 올려 두는 기능(핫 로드)을 제공하지 않습니다.** 새로 뜨는 인스턴스는 매번 처음부터 준비를 마쳐야 하며, 이 준비 시간을 설정으로 줄일 방법은 없습니다.
그래서 아래 세 가지가 사실상 유일한 대응입니다.
1. **최소 개수를 올려 미리 띄워 둡니다.** 몰리는 시간대를 알고 있다면 그 전에 최소를 올려 두는 것이 가장 확실합니다. 한가한 시간에 GPU를 점유하는 대신, 정작 필요한 순간에 기다리지 않습니다.
2. **축소 대기 시간을 짧게 두지 않습니다.** 기본값 600초는 이 기동 비용을 감안한 값입니다.
3. **증설 지속 시간도 기본값(120초)을 유지합니다.** 순간 부하에 반응해 늘려도 그 인스턴스는 몇 분 뒤에나 준비되므로, 이미 지나간 부하를 뒤늦게 받게 됩니다.
> 이 때문에 모델 서빙에서 "부하가 오르는 순간의 지연"은 자동 확장으로 해결되지 않습니다. 자동 확장은 **몇 분 이상 이어지는 부하**를 감당하는 수단이고, 짧은 스파이크는 최소 개수로 흡수하는 것이 맞습니다.
## 증설 기준 근처에서 신호가 오르내릴 때
부하가 증설 기준 언저리에서 오르내리면 계산 결과가 한 개 차이로 계속 뒤집힙니다. 증설 기준 5에 대기 건수가 10건과 11건 사이를 오가면 필요한 개수가 2개↔3개로 번갈아 나오는 식입니다.
시스템이 기본적으로 막아 주는 부분이 있습니다. 늘릴 때는 증설 지속 시간(기본 120초) 구간의 최솟값을 보므로 순간적으로만 넘긴 부하로는 늘어나지 않고, 줄일 때는 축소 대기 시간(기본 600초) 동안 계속 낮아야 합니다. 그래서 짧은 흔들림은 대개 개수 변화로 이어지지 않습니다.
그럼에도 "현재 N개 실행 중"이 몇 분 간격으로 오간다면 아래 순서로 조정합니다.
1. **축소 대기 시간을 늘립니다.** 600초 → 900초. 가장 부작용이 적고 효과가 확실합니다. GPU를 조금 더 오래 점유하는 대신 왕복이 사라집니다.
2. **증설 기준을 평상시 부하보다 위로 옮깁니다.** 평소 대기가 10건 안팎이면 기준 5는 정확히 경계에 걸립니다. 8로 올리면 평소에는 2개로 안정되고 진짜 몰릴 때만 늘어납니다.
3. **증설 지속 시간을 올립니다.** 120초 → 300초. 콜드 스타트 비용을 생각하면 모델 서빙에서는 이 방향이 손해가 아닙니다.
경계에 딱 맞는 값보다 **여유를 둔 값**이 안정적입니다. 기준을 정확히 맞추려 할수록 왕복이 잘 생깁니다.
***
## 결정 가이드
### 1. 고정과 자동 중 무엇을 고를까
**고정**은 입력한 개수를 항상 유지합니다. GPU 점유량이 일정해 예산·쿼터 계획을 세우기 쉽고, 동작을 예상하기 쉽습니다. 트래픽이 대체로 일정하거나, 응답 지연을 어떤 상황에서도 일정하게 유지해야 하는 서비스라면 고정이 적합합니다.
**자동**은 신호를 주기적으로 확인해 최소\~최대 사이에서 개수를 조절합니다. 시간대나 이벤트에 따라 트래픽 편차가 크고, 한가한 시간에 GPU를 돌려주는 이득이 큰 경우에 적합합니다.
다만 모델 서빙에는 자동을 고르기 전에 반드시 확인할 조건이 있습니다 — **아래 2·3번**을 먼저 읽으세요. 조건이 맞지 않으면 자동으로 두어도 인스턴스가 늘지 않아, 결과적으로 최소 개수로 고정한 것과 같아집니다.
### 2. 확장 신호 — 리비전마다 고를 수 있는 것이 다릅니다
| 엔진 | 고를 수 있는 신호 |
| -------------------------------------------- | ------------------------- |
| **LLM 계열** (vLLM 기반 — LLM · 임베딩 · 리랭킹 · VLM) | **큐만** — 드롭다운에 큐 하나만 나옵니다 |
| **Triton** | **큐 · CPU** — 둘 중에서 고릅니다 |
Triton 리비전 — 큐와 CPU 중에서 고릅니다
**LLM 계열에서 CPU가 후보로 나오지 않는 이유**는, 연산이 GPU에서 일어나 파드 CPU가 거의 움직이지 않기 때문입니다. 켜더라도 사용률이 오르지 않아 증설되지 않습니다. 화면에도 `CPU 사용률은 CPU로 추론하는 서빙에서만 부하를 대변합니다`라는 안내가 함께 표시됩니다.
**Triton에만 CPU가 열려 있는 이유**는 Triton 리비전은 **GPU 할당량을 "사용하지 않음"으로 두고 CPU로 추론하는 구성이 가능**하기 때문입니다. 이런 리비전에서는 요청이 몰릴 때 파드 CPU가 실제로 올라가므로 사용률이 부하를 그대로 대변하고, 사용률이 일정 시간 이상 기준을 넘으면 인스턴스를 늘리는 방식이 성립합니다. GPU를 할당한 Triton 리비전에서는 이 신호가 잘 오르지 않으니 큐를 고르세요.
CPU 추론 프레임워크(ONNX Runtime · OpenVINO 등)를 쓰는 경우에는, 해당 프레임워크를 지원하는 서빙 이미지와 그에 맞는 config.pbtxt 또는 model.py 작성이 필요합니다.
CPU 신호에는 실무적인 장점이 하나 더 있습니다. **프로메테우스 설정이 필요 없습니다** — 큐 신호와 달리 클러스터 기본 지표 경로를 쓰기 때문에, 프로메테우스가 준비되지 않은 사이트에서도 CPU 추론 Triton 리비전은 자동 확장을 쓸 수 있습니다.
큐 신호는 **프로메테우스 설정이 된 사이트에서만** 고를 수 있습니다. Triton 리비전은 여기에 더해 엔진 지표 수집 설정(8002 포트)이 사이트에 되어 있어야 합니다. 이 설정은 GenOS가 자동으로 만들지 않는 **사이트 설치 항목**이라, 빠져 있으면 화면에서는 자동으로 켜지지만 실제로는 절대 늘어나지 않습니다.
> **Triton 리비전은 큐·CPU 둘 다 실제로 동작합니다.** 큐는 부하 시 대기열이 형성되어 인스턴스가 늘어나는 것이, CPU는 사용률 기반 증설·축소가 각각 확인됐습니다. 요청이 몰리는 만큼 늘리고 싶다면 큐, CPU를 많이 쓰는 모델이라면 CPU가 적합합니다.
> 고를 수 있는 신호가 하나도 없으면 화면에 안내가 표시되며, 이 경우 고정 방식을 사용합니다.
### 3. 큐 신호가 실제로 동작하는 조건 — 자동을 고르기 전 확인
큐 신호는 **엔진이 아직 처리에 들어가지 못하고 기다리는 요청 수**를 셉니다. 이미 처리 중인 요청은 세지 않습니다.
여기서 엔진의 성질이 갈립니다. 추론 엔진은 여러 요청을 한꺼번에 묶어 동시에 처리하는데(배칭), **한 번에 묶는 개수가 엔진마다 크게 다릅니다.** 요청이 그 개수를 넘지 않으면 대기열이 생기지 않고, 큐 신호는 0으로 유지됩니다.
| 엔진 | 한 번에 묶는 개수 | 큐 신호 |
| ---------- | ---------------- | ------------------------------------ |
| **Triton** | 모델 설정값, 보통 한 자릿수 | **잘 동작합니다** — 요청이 조금만 몰려도 대기열이 형성됩니다 |
| **LLM 계열** | 기본 수백 건 | **거의 형성되지 않습니다** — 아래 설명 참고 |
**LLM 계열에서 큐 신호가 잘 늘지 않는 이유.** 게이트웨이가 한 리비전으로 동시에 흘려보내는 요청 수는 **최대 동시 실행 수**로 제한되는데(리비전 생성 시 지정, 1\~200, 기본 10), 엔진이 한 번에 묶는 개수가 그보다 큽니다. 그래서 요청이 아무리 몰려도 엔진 입장에서는 여유가 남고, 대기열이 생기지 않습니다. 최대 동시 실행 수를 **상한인 200까지 올려도 마찬가지**임이 확인돼 있습니다 — 이 값을 올리는 것은 해결책이 아닙니다.
```
요청 몰림 → [게이트웨이: 최대 동시 실행 수만큼 통과] → [엔진: 배치로 동시 처리]
↑
큐 신호는 여기를 봅니다
```
**정리하면 이렇게 고르세요.**
| 상황 | 권장 |
| ------------------------------------ | -------------------------------- |
| Triton 리비전 | **자동 · 큐** (또는 CPU) |
| LLM 계열이고, 엔진 배치 크기를 의도적으로 작게 잡아 운영 중 | 자동 · 큐 |
| LLM 계열 **기본 구성** | **고정** — 자동으로 둬도 늘지 않을 가능성이 높습니다 |
> **판단이 서지 않으면 이렇게 확인하세요.** 자동·큐로 저장한 뒤 실제 부하를 인가하고, 증설 지속 시간(기본 120초)이 지나도 인스턴스가 최소 개수 그대로라면 이 리비전에서는 큐 신호가 형성되지 않는 것입니다. 최대 동시 실행 수를 올려서 해결되는 문제가 아니므로, 고정 방식으로 전환하고 필요한 개수를 직접 지정하세요.
### 4. 최소·최대 정하기
최소는 부하가 없어도 항상 유지되므로 그만큼 GPU를 상시 점유합니다. 다만 모델 서빙은 콜드 스타트가 길어, **응답 지연에 민감한 서비스라면 최소를 2 이상으로 두는 것이 유일한 대비책**입니다. 지연에 여유가 있다면 1로 두는 편이 자원 효율이 좋습니다.
최대는 **GPU 쿼터 잔여량으로 한 번 더 제한됩니다.** 쿼터가 부족하면 입력한 값보다 작게 조정되며, 카탈로그로 가져온 리비전은 `카탈로그 원본은 최대 N개였으나 이 환경의 GPU 쿼터로 M개로 조정되었습니다` 안내가 표시됩니다. 최대를 늘리려면 먼저 쿼터를 확보해야 합니다.
***
## 사용할 수 없는 경우
| 상황 | 이유 |
| --------------------- | ------------------------------------------------------------------------------------------------------- |
| **LoRA 어댑터가 연결된 리비전** | LoRA 리비전은 베이스 리비전의 인스턴스를 공유해 확장 대상이 없고, 베이스를 늘리면 새로 뜬 인스턴스에 어댑터가 로드되지 않아 LoRA 모델 호출이 실패합니다. 저장 시 거부됩니다. |
| **여러 노드에 걸쳐 배포된 서빙** | 노드를 나눠 한 모델을 띄우는 구성은 일부만 늘리면 구성이 깨집니다. |
| **자동 확장 미지원 사이트** | 클러스터에 자동 확장 구성 요소가 설치되지 않은 환경에서는 고정 방식만 사용합니다. |
## 자주 만나는 안내 문구
| 문구 | 의미와 해결 방법 |
| ------------------------------------------- | ---------------------------------------------------------------- |
| 이 리비전에서 사용할 수 있는 확장 신호가 없습니다 | GPU 기반 엔진은 CPU 신호를 쓸 수 없고, 큐 신호는 프로메테우스 설정이 필요합니다. 고정 방식을 사용합니다. |
| LoRA 어댑터가 연결된 리비전은 실행 확장을 사용할 수 없습니다 | 베이스 리비전을 늘려도 어댑터가 로드되지 않습니다. 확장 대상이 아닙니다. |
| 카탈로그 원본은 최대 N개였으나 이 환경의 GPU 쿼터로 M개로 조정되었습니다 | 최대가 이 환경 기준으로 낮춰졌습니다. 늘리려면 쿼터를 확보합니다. |
| 현재 배포 중이 아닙니다 — 저장한 설정은 다음 배포 때 적용됩니다 | 지금은 반영되지 않고 다음 배포 때 적용됩니다. |
| 정수만 입력할 수 있습니다 / N 이상 M 이하로 입력하세요 | 상세 설정 값이 허용 범위를 벗어났습니다. 고쳐야 저장됩니다. |
| 비워두면 기본값 N 사용 | 오류가 아닙니다. 비운 채 저장하면 N으로 저장됩니다. |
| 실행 확장 설정을 불러오지 못했습니다 | 잠시 후 다시 시도합니다. |
| 실행 확장(HA) 설정 저장에 실패했습니다 | 저장이 반영되지 않았습니다. 값을 확인하고 다시 저장합니다. |
## 자동으로 뒀는데 늘지 않을 때
순서대로 확인하세요.
1. **화면에 표시된 현재 인스턴스 수가 최소 그대로인가** — 최대까지 이미 늘었는데 부족한 것이라면 최대와 GPU 쿼터를 확인합니다.
2. **증설 지속 시간이 지났는가** — 기본 120초 동안 부하가 유지되어야 늘어납니다.
3. **증설 동작이 Disabled인가** — Disabled면 자동으로 늘지 않습니다. Max로 되돌립니다.
4. **확장 신호가 큐인가** — 그렇다면 결정 가이드 3번의 조건에 해당하는지 확인합니다. 이 경우 증설 기준을 낮추거나 최대 동시 실행 수를 올려도 해결되지 않으며, 고정 방식으로 전환하는 것이 맞습니다.
5. **지표 조회가 계속 실패하고 있지 않은가** — 실패가 허용 횟수를 넘기면 개수가 최소로 고정됩니다. 관리자에게 프로메테우스 상태를 확인합니다.
6. **늘긴 늘었는데 느린 것은 아닌가** — 증설 폭이 기본값(60초에 1개)이면 최대까지 도달하는 데 몇 분이 걸리고, 여기에 콜드 스타트가 더해집니다. 더 빨리 늘려야 한다면 증설 폭 값을 올립니다.
7. **Triton 리비전인가** — Triton은 큐 신호가 정상 동작하므로, 늘지 않는다면 사이트에 엔진 지표 수집 설정(8002 포트)이 되어 있는지 관리자에게 확인하세요. 배선이 빠져 있으면 신호가 항상 0으로 보입니다.
8. 위를 모두 확인해도 늘지 않으면 **고정 방식으로 전환**해 필요한 개수를 직접 지정하고, 담당자에게 리비전 번호와 함께 문의하세요.
## 사용자 시나리오
### 사내 챗봇 LLM 서빙 — 업무 시간에만 쓰이는 경우
LLM 계열 기본 구성이라 큐 신호가 형성되지 않아 자동으로 두어도 늘지 않습니다. 확장 방식을 **고정**으로 두고 업무 시간대에 필요한 개수(예: 2개)를 지정합니다. 야간에 GPU를 회수하려면 확장 방식을 그대로 두고 개수만 1로 바꿔 저장하면 되며, 배포 중인 리비전은 저장 즉시 반영됩니다.
### Triton 임베딩 서빙 — 배치 색인 작업이 몰리는 경우
Triton은 대기열이 실제로 형성되므로 **자동 · 큐**가 맞습니다. 최소 1 / 최대 4, 증설 기준은 기본값 5로 시작합니다. 색인이 시작되면 대기가 쌓여 증설 지속 시간(120초) 뒤부터 60초에 한 개씩 늘어나고, 작업이 끝나고 600초가 지나면 최소로 돌아갑니다. 색인이 짧게 끝나 늘어나기 전에 작업이 종료된다면 증설 지속 시간을 30\~60초로 낮춥니다.
### Triton 서빙에서 CPU 사용률이 먼저 한계에 닿는 경우
CPU로 전처리·후처리를 많이 하는 모델이라면 **자동 · CPU**를 고릅니다. 증설 기준은 기본 70%로 시작하고, 부하가 분명한데 늘지 않으면 40\~50%로 낮춰 확인합니다. 인스턴스 안에는 앱 외의 컨테이너도 함께 뜨므로 인스턴스가 작을수록 전체 사용률이 70%에 닿기 어렵습니다.
### 이벤트 시각에 요청이 한꺼번에 몰리는 경우
콜드 스타트 때문에 몰리는 순간에 늘리기 시작해서는 늦습니다. **이벤트 전에 최소를 미리 올려** 인스턴스를 띄워 두고, 이벤트 중에는 증설 폭 값을 2로 올려 부족분을 빠르게 채웁니다. 이벤트가 끝나면 최소와 증설 폭을 원래대로 되돌립니다.
### 늘어난 인스턴스를 이벤트 동안 유지하고 싶은 경우
축소 동작을 **Disabled**로 두면 부하가 내려가도 줄어들지 않습니다. 반복적인 축소·재증설을 막는 데 유용하지만, 끝난 뒤 반드시 Max로 되돌려야 합니다 — 그대로 두면 GPU를 계속 점유합니다.
### 축소될 때 긴 생성 요청이 끊기는 경우
기본 축소 폭(15초에 100%)은 축소 대기 시간이 지나면 한 번에 최소까지 내려갑니다. 축소 폭을 **개수 / 1 / 60초**로 바꾸면 60초에 하나씩 내려가므로, 종료되는 인스턴스가 한꺼번에 생기지 않습니다. 축소 대기 시간도 900초 이상으로 올립니다.
### 인스턴스가 2개와 3개를 계속 오가는 경우
평상시 부하가 증설 기준 경계에 걸려 계산 결과가 한 개 차이로 뒤집히는 경우입니다. 축소 대기 시간을 600초에서 900초로 올리고, 그래도 왕복하면 증설 기준을 평상시 부하보다 위로 옮깁니다 — 대기가 평소 10건 안팎이라면 기준 5를 8로 올려 평소 2개로 안정시킵니다.
### 값을 여러 개 바꿨다가 원래대로 돌리고 싶은 경우
바꾼 칸을 **비우고 저장**하면 각 항목의 기본값으로 돌아갑니다. 칸을 비우면 그 아래에 "비워두면 기본값 N 사용"이 표시되므로, 저장 전에 어떤 값으로 돌아가는지 확인할 수 있습니다.
## 함께 보기
* [코드 서빙 실행 확장(HA)](/default/v1.9.3/basic-tutorials/guides/development/code_serving/ha-autoscale.md)
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://genos-docs.gitbook.io/default/v1.9.3/basic-tutorials/guides/llm/model-serving-ha.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.