> For the complete documentation index, see [llms.txt](https://genos-docs.gitbook.io/default/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://genos-docs.gitbook.io/default/v1.9.3/basic-tutorials/guides/metric.md).

# 평가 지표

## 평가 지표

### 개요

**평가 > 평가지표 > Langfuse**는 워크플로우가 실제로 처리한 요청(운영 트레이스)을 LLM 판정 모델로 자동 채점하기 위한 메뉴입니다. 데이터셋을 준비해 단발성으로 돌리는 기존 평가와 달리, 운영 중 쌓이는 트레이스에 평가 점수를 상시 누적합니다.

사용 구조는 두 단계로 나뉩니다. 먼저 이 메뉴에서 채점 방식을 정의한 **Custom Evaluator**(프롬프트 3종 + 판정 모델)를 만들고, 그다음 **에이전트 > 워크플로우 > 워크플로우 상세 > 이용 로그**에서 그 Evaluator를 특정 워크플로우에 적용하는 **평가 기준**(대상 노드 · 필터 · 샘플링)을 만듭니다. 평가 기준을 활성화하면 그 이후 수집되는 요청부터 채점되고, 점수는 이용 로그의 `평가점수` 컬럼에 표시됩니다.

Evaluator는 Langfuse가 원본(source of truth)이며 GenOS는 메타데이터와 조회 캐시를 보관합니다. 화면 용어도 Langfuse 원문(Custom Evaluator · score · Filter · Sampling · Variable mapping)을 그대로 사용합니다.

### 주요 개념

| 개념                                           | 설명                                                                                                                                                                 |
| -------------------------------------------- | ------------------------------------------------------------------------------------------------------------------------------------------------------------------ |
| Custom Evaluator                             | 채점 방식을 정의한 템플릿입니다. 프롬프트 3종(평가·점수 근거·점수 출력)과 판정 모델(모델 서빙)로 구성되며, 어떤 요청을 평가할지는 담고 있지 않습니다.                                                                           |
| 평가 기준                                        | Custom Evaluator를 특정 워크플로우에 적용한 단위입니다. 대상 노드·필터·샘플링과 score 이름을 갖습니다. Evaluator 하나로 조건이 다른 평가 기준을 여러 개 만들 수 있습니다.                                                   |
| 판정 모델                                        | 채점을 수행하는 LLM입니다. 모델 서빙 메뉴에서 배포된 LLM·VLM 서빙 중에서 선택합니다.                                                                                                              |
| LLM Connection                               | Langfuse가 판정 모델을 호출하기 위한 연결 정보입니다. Evaluator를 만들 때 자동으로 등록·재사용되며 별도 관리 화면은 없습니다.                                                                                   |
| score                                        | 트레이스에 기록되는 점수입니다. 0\~1 사이 숫자 값으로 산출됩니다.                                                                                                                            |
| 트레이스 / observation                           | 트레이스는 워크플로우 실행 1건, observation은 그 안의 개별 단계(LLM 호출·검색 등)입니다. 평가 대상은 대상 노드 설정에 따라 둘 중 하나가 됩니다.                                                                       |
| 샘플링(Sampling)                                | 조건에 맞는 트레이스 중 실제로 평가할 비율입니다. 100%면 모두 평가하고, 70%면 새로 쌓이는 트레이스가 평가될 확률이 70%입니다.                                                                                      |
| 정답(Ground Truth)                             | 질문에 대한 정답을 미리 등록해 둔 데이터입니다. `question` · `answer` · `source` 컬럼의 CSV로 적재하며, 사용자 질문과 유사한 질문이 검색되면 그 정답이 응답의 `metadata.sourceDocuments`에 실려 평가에 사용됩니다.               |
| Ground Truth Retriever / Use as Ground Truth | 워크플로우에서 정답 데이터를 연결하는 입력과 설정입니다. chatflow는 `Mnc Unified RAG Chain`의 `Ground Truth Retriever` 입력, agentflow는 Agent 노드 Vector Store의 `Use as Ground Truth` 토글을 사용합니다. |

### 평가지표 Langfuse(Evaluator) 목록

**평가 > 평가지표 > Langfuse**로 진입합니다(`/evaluation/metric/langfuse`). 등록된 Custom Evaluator를 목록으로 확인하고 생성·수정·삭제합니다.

<figure><img src="https://541419907-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FKhN1XWFV3oOVnFMMIHTE%2Fuploads%2Fgit-blob-0b7fe72e6ecc42e4fd3d223ca6f6219c88fcf976%2Fmetric193_01_evaluator-list.png?alt=media" alt="평가지표 Langfuse(Evaluator) 목록 — 검색·컬럼·Custom Evaluator 생성 버튼"><figcaption><p>평가지표 Langfuse(Evaluator) 목록 — 검색·컬럼·Custom Evaluator 생성 버튼</p></figcaption></figure>

| 컬럼            | 설명                                                              |
| ------------- | --------------------------------------------------------------- |
| ID            | Evaluator 채번 ID                                                 |
| Evaluator 이름  | Langfuse에 등록된 이름. 클릭하면 상세로 이동                                   |
| 판정 모델 (모델 서빙) | `{모델명} : {리비전}` 형식. 리비전을 지정하지 않았으면 `리비전 미지정`                    |
| 사용 중          | 이 Evaluator를 적용한 평가 기준 건수. 없으면 `-`                              |
| 관리 그룹         | Evaluator가 속한 관리 그룹                                             |
| 생성자 / 생성일시    | 생성자 이름과 생성일시. 생성자에 마우스를 올리면 로그인 아이디가 툴팁으로 표시되고, 클릭하면 사용자 상세로 이동 |
| 관리            | 행 액션 메뉴(수정 · 삭제)                                                |

기본 정렬은 생성일시 최신순입니다. 검색은 좌측 드롭다운에서 검색 대상을 고른 뒤 검색어를 입력하며, 정렬은 컬럼 헤더를 클릭합니다. 정렬을 바꾸면 목록은 1페이지로 돌아갑니다. 등록된 Evaluator가 없으면 "등록된 Custom Evaluator가 없습니다." 안내가 표시됩니다.

`사용 중` 건수는 활성·비활성 평가 기준을 모두 합한 전체 건수입니다. 비활성은 평가를 잠시 멈춘 상태이지 연결이 끊긴 상태가 아니므로, 삭제 가능 여부도 이 전체 건수로 판단합니다.

우측 상단 **\[Custom Evaluator 생성]** 버튼은 평가지표 쓰기 권한이 있을 때만 표시됩니다. 행 액션과 상세의 수정 버튼은 해당 관리 그룹에 쓰기 권한이 있는 사용자에게만 노출됩니다.

### Custom Evaluator 생성

목록 우측 상단 \*\*\[Custom Evaluator 생성]\*\*을 누르면 생성 모달이 열립니다. 모달 상단에 "프롬프트와 판정 모델로 Langfuse Custom Evaluator를 만듭니다. 적용 대상·필터·샘플링은 워크플로우 이용 로그에서 평가 기준으로 지정합니다."라는 안내가 표시됩니다.

<figure><img src="https://541419907-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FKhN1XWFV3oOVnFMMIHTE%2Fuploads%2Fgit-blob-2570941624c777aa1de69dac9ef86d55cbdf16a9%2Fmetric193_02_evaluator-create-modal.png?alt=media" alt="Custom Evaluator 생성 모달 상단 — 이름·설명·관리 그룹·모델 서빙"><figcaption><p>Custom Evaluator 생성 모달 상단 — 이름·설명·관리 그룹·모델 서빙</p></figcaption></figure>

| 입력 항목        | 필수 | 설명                                                                            |
| ------------ | -- | ----------------------------------------------------------------------------- |
| Evaluator 이름 | 필수 | 최대 64자. Langfuse에 등록되는 이름입니다. 한 줄로만 입력하며, 이미 사용 중인 이름은 저장할 수 없습니다             |
| 상세 설명        | 선택 | 최대 1024자. Evaluator의 용도를 설명하며 카탈로그 등록 시 함께 노출됩니다                              |
| 관리 그룹        | 필수 | 접근·수정 권한이 결정되는 관리 그룹입니다                                                       |
| 모델 서빙        | 필수 | 판정을 수행할 모델 서빙입니다                                                              |
| 리비전          | 선택 | 서빙 안의 특정 리비전. 지정하지 않으면 서빙의 트래픽 분배 정책에 따라 호출됩니다                                |
| 평가 프롬프트      | 필수 | llm-as-a-judge 평가 템플릿입니다. 평가할 내용은 `{{input}}` 같은 변수로 참조합니다                    |
| 점수 근거 프롬프트   | 필수 | 최대 1024자. LLM이 평가 근거를 설명하는 방식입니다. 근거가 점수보다 먼저 생성되어 chain-of-thought 추론이 가능합니다 |
| 점수 출력 프롬프트   | 필수 | 최대 1024자. LLM이 점수를 반환하는 방식입니다. 0\~1 사이 숫자 값이 산출되어야 합니다                        |

이름·설명에는 `\ / : * ? " < > |` 문자를 사용할 수 없고, 공백만 입력할 수도 없습니다. 글자 수는 입력란 우측에 카운터로 표시됩니다. **\[저장]** 버튼은 필수 항목을 모두 채우기 전까지 비활성 상태입니다.

점수 근거·점수 출력 프롬프트에는 기본 문구가 미리 채워져 있어 그대로 사용할 수 있습니다.

* 점수 근거 프롬프트 기본값 — `부여한 점수를 한 문장으로 간결하게 설명하라.`
* 점수 출력 프롬프트 기본값 — `0에서 1 사이의 숫자로 반환하라. 0이 최저, 1이 최고 점수다.`

#### 모델 서빙 선택과 LLM Connection

모델 서빙 선택 영역에는 다음 안내가 상시 표시됩니다.

> 선택한 모델 서빙은 Langfuse LLM Connection으로 자동 등록됩니다. 없으면 생성하고 동일 provider Connection이 있으면 저장 시 현재 설정으로 갱신하며, Evaluator를 수정·삭제할 때 사용되지 않는 Connection은 함께 정리합니다. 별도 등록·관리 화면은 제공하지 않습니다.

즉 사용자가 Langfuse 연결 정보를 직접 등록할 필요는 없습니다. 모델 서빙 선택 창에는 **배포 상태이고 접근 권한이 있는 LLM·VLM 서빙만** 표시되며, 전체 / LLM / VLM 탭으로 유형을 나눠 볼 수 있고 서빙명으로 검색할 수 있습니다. 리비전 항목은 모델 서빙을 먼저 선택해야 활성화됩니다(선택 전에는 "모델 서빙 먼저 선택"으로 표시).

정책상, 이번 코드로 신규 생성되거나 Evaluator 수정으로 다시 등록된 내부 모델 서빙 connection의 자동 평가 호출은 검증된 플랫폼 작업으로 처리하도록 구성됩니다. 정상 적용 시 Evaluator 생성자나 관리자의 Credit을 사용하지 않고 0원 감사 이력을 남깁니다. 외부 API 서빙을 선택하면 Langfuse가 등록된 외부 provider를 직접 호출하므로 정책상 GenOS 크레딧 원장을 만들지 않고 provider의 기존 인증과 비용 계약을 따릅니다. 실제 배포의 score·provider 호출·원장 결과는 배포 후 수용 테스트에서 확인합니다. 이 정책은 모델 서빙 화면에서 관리자가 직접 실행하는 수동 테스트의 관리자 과금 정책을 바꾸지 않습니다.

기존 connection은 코드 배포만으로 갱신되지 않습니다. 승인된 재동기화와 저장 상태 확인이 끝나기 전에는 새 면제 정책이 적용됐다고 보지 않습니다.

#### 프롬프트 예시

프롬프트 섹션 우측의 **\[프롬프트 예시]** 드롭다운에서 항목을 고르면 평가 프롬프트가 예시 내용으로 채워집니다. Langfuse가 제공하는 평가 템플릿 기준으로 다음 항목이 제공됩니다.

`Answer Correctness` · `Answer Critic` · `Answer Relevance` · `Conciseness` · `Context Precision` · `Context Recall` · `Contextcorrectness` · `Contextrelevance` · `Correctness` · `Faithfulness` · `Goal Accuracy` · `Hallucination` · `Helpfulness` · `Out-of-Scope Request` · `Relevance` · `SQL Semantic Equivalence` · `Simple Criteria` · `Topic Adherence Classification` · `Topic Adherence Refusal` · `Toxicity` · `User Disagreement` · `User Distress`

목록이 길어 페이지 단위로 나눠 표시되며, 예시가 없으면 "예시가 없습니다"로 표시됩니다.

<figure><img src="https://541419907-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FKhN1XWFV3oOVnFMMIHTE%2Fuploads%2Fgit-blob-d27bb8ffaf4e1af3d66a311774aa1356a02267a8%2Fmetric193_03_prompt-examples.png?alt=media" alt="프롬프트 예시 드롭다운을 펼친 상태"><figcaption><p>프롬프트 예시 드롭다운을 펼친 상태</p></figcaption></figure>

#### 저장 결과

저장에 성공하면 "Custom Evaluator가 생성 되었습니다" 토스트가 표시되고 목록이 갱신됩니다. 입력 중 모달을 닫으려 하면 "입력한 내용이 저장되지 않습니다. 닫으시겠습니까?" 확인을 거칩니다.

### Custom Evaluator 상세

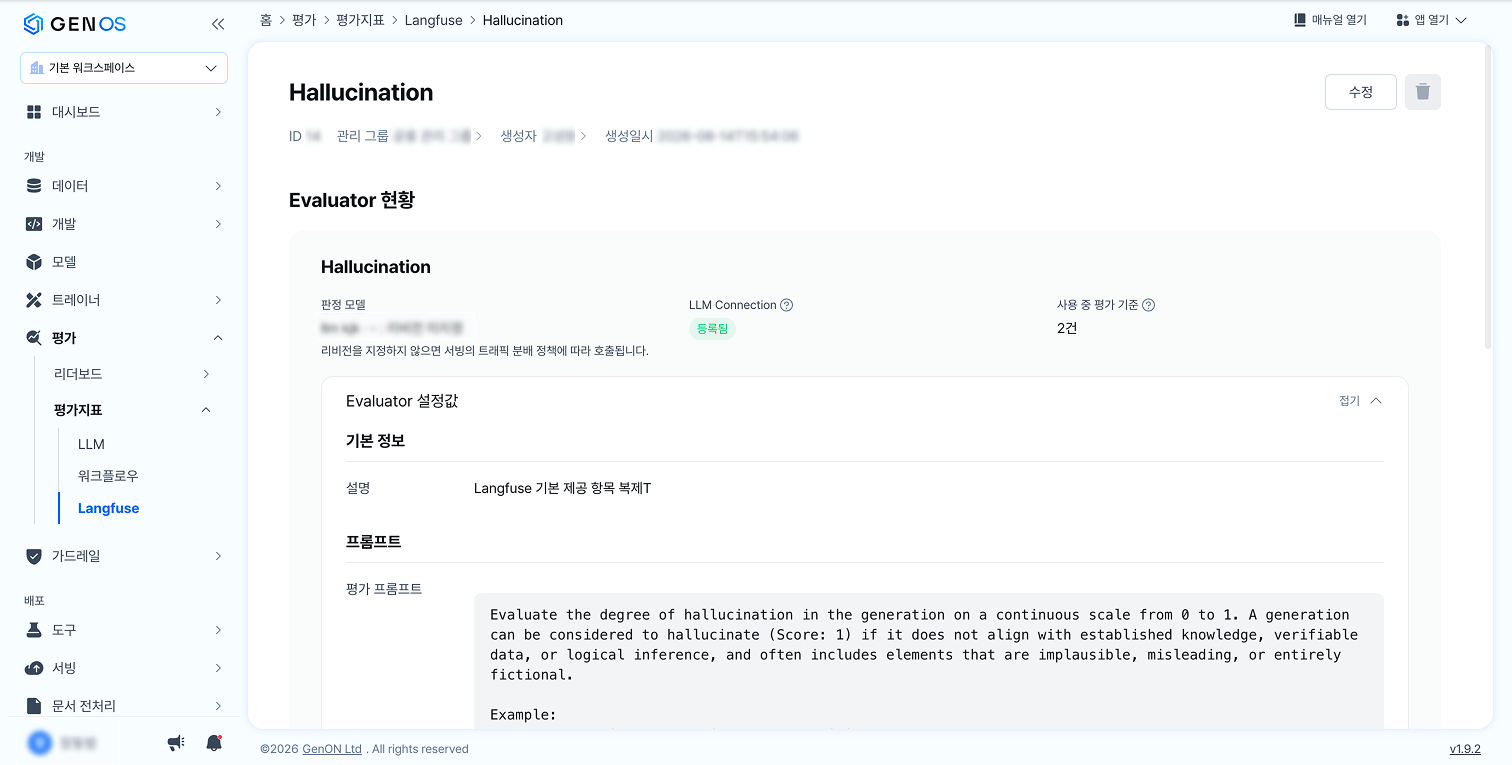
목록에서 Evaluator 이름 또는 행을 클릭하면 상세로 이동합니다(`/evaluation/metric/langfuse/detail/{id}`). 상세는 탭 없이 세 단으로 구성됩니다.

<figure><img src="https://541419907-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FKhN1XWFV3oOVnFMMIHTE%2Fuploads%2Fgit-blob-9c018c5a2464084459aaaab4037a2dc36a1c46d9%2Fmetric193_04_evaluator-detail.png?alt=media" alt="Evaluator 상세 — 헤더·Evaluator 현황·설정값 아코디언"><figcaption><p>Evaluator 상세 — 헤더·Evaluator 현황·설정값 아코디언</p></figcaption></figure>

**1. 헤더** — Evaluator 이름과 ID · 관리 그룹 · 생성자 · 생성일시가 표시되고, 우측에 \*\*\[수정]\*\*과 삭제 버튼이 있습니다.

**2. Evaluator 현황** — 요약 카드에 다음 3개 항목이 표시됩니다.

| 항목             | 설명                                                                                                  |
| -------------- | --------------------------------------------------------------------------------------------------- |
| 판정 모델          | `{서빙명} · {모델명} : {리비전}` 형식. 리비전을 지정하지 않았으면 "리비전을 지정하지 않으면 서빙의 트래픽 분배 정책에 따라 호출됩니다." 보조 문구가 함께 표시됩니다 |
| LLM Connection | `등록됨` / `미등록` 뱃지                                                                                    |
| 사용 중 평가 기준     | 이 Evaluator를 적용한 평가 기준 수. 접근 권한이 없는 워크플로우의 평가 기준도 포함되므로 아래 목록에 표시되지 않을 수 있습니다                       |

카드 안의 **Evaluator 설정값** 아코디언을 펼치면 기본 정보(설명)와 프롬프트 3종을 확인할 수 있습니다. 평가 프롬프트는 `{{context}}` 같은 변수를 원문 그대로 보여주기 위해 코드 블록 형태로 표시됩니다. 아코디언 접힘 상태는 저장되지 않아 재진입 시 항상 펼쳐진 상태로 시작합니다.

배포 상태가 아닌 서빙을 판정 모델로 쓰고 있으면 서빙 상태 뱃지가 함께 표시되고, 서빙이 삭제된 경우에는 뱃지 대신 비활성 톤으로 표시됩니다.

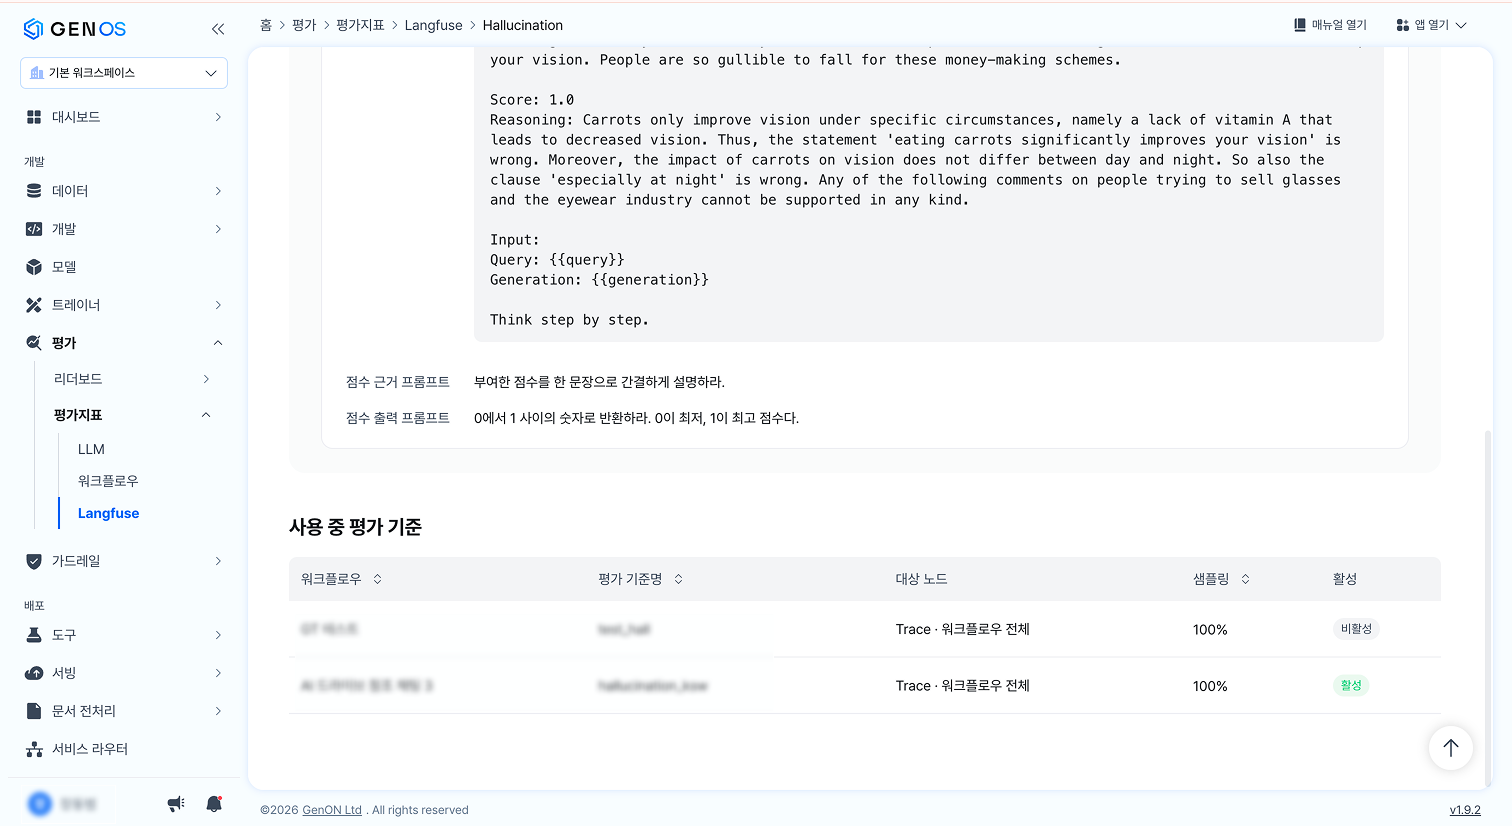
**3. 사용 중 평가 기준** — 이 Evaluator를 적용한 평가 기준을 표로 보여줍니다.

<figure><img src="https://541419907-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FKhN1XWFV3oOVnFMMIHTE%2Fuploads%2Fgit-blob-a278ac94151f8fc211e91dda1206789014b9c303%2Fmetric193_05_in-use-rules.png?alt=media" alt="상세 하단 사용 중 평가 기준 표"><figcaption><p>상세 하단 사용 중 평가 기준 표</p></figcaption></figure>

| 컬럼     | 설명                                         |
| ------ | ------------------------------------------ |
| 워크플로우  | 평가 기준이 적용된 워크플로우                           |
| 평가 기준명 | 트레이스에 남는 score 이름                          |
| 대상 노드  | `Trace · 워크플로우 전체` 또는 `Observation · {노드}` |
| 샘플링    | 평가 비율(%)                                   |
| 활성     | `활성` / `비활성` 뱃지                            |

이 표에는 **접근 권한이 있는 워크플로우의 평가 기준만** 표시됩니다. 따라서 위 요약 카드의 `사용 중 평가 기준` 건수가 1건 이상인데 표는 비어 있을 수 있으며, 이는 정상 동작입니다. 사용 중인 평가 기준이 없으면 "사용 중인 평가 기준이 없습니다."로 표시됩니다.

### Custom Evaluator 수정·삭제

수정은 목록 행 액션 또는 상세 헤더의 \*\*\[수정]\*\*으로 진입하며, 생성과 같은 폼에 기존 값이 채워진 상태로 열립니다. 이름·설명 변경도 이 경로에서만 합니다(별도 인라인 수정은 제공하지 않습니다). 값을 불러오는 동안 입력이 잠기며, 저장하면 "Custom Evaluator가 성공적으로 수정 되었습니다" 토스트가 표시됩니다.

이미 점수가 쌓인 Evaluator의 평가 프롬프트에서 변수를 바꾸면 저장이 거부되고 다음 안내가 표시됩니다.

> 해당 템플릿을 사용하고 있는 점수가 존재하고 있어서 변수 수정이 불가능합니다. 평가 프롬프트의 변수를 유지한 채로 수정해주세요.

삭제는 사용 중인 평가 기준이 하나도 없을 때만 가능합니다. 사용 중이면 삭제 버튼이 비활성화되고 툴팁으로 "사용 중인 평가 기준이 있어 삭제할 수 없습니다. 평가 기준을 모두 삭제한 뒤 다시 시도해 주세요."가 안내됩니다.

삭제 가능한 경우 재확인 모달(**Custom Evaluator 삭제**)이 열립니다. "이 작업은 되돌릴 수 없습니다. 그래도 진행하시려면 아래 문자를 입력하세요." 안내와 함께 **삭제할 Evaluator의 이름을 그대로 입력**해야 하며, 고정 문구가 아닙니다. 입력값이 다르면 "이름이 일치하지 않습니다." 인라인 오류가 표시되고, 다시 입력하면 즉시 해제됩니다. 버튼은 \*\*\[닫기]\*\*와 \*\*\[삭제]\*\*입니다.

삭제 시 Langfuse의 Evaluator가 먼저 삭제되고, 그 판정 모델을 쓰는 다른 활성 Evaluator가 없으면 LLM Connection도 함께 정리됩니다. Langfuse 삭제가 실패하면 GenOS 쪽 상태는 변경되지 않습니다.

### 정답(Ground Truth) 기반 평가 준비

`Answer Correctness`처럼 정답과 대조해 채점하는 Evaluator는 트레이스에 정답이 함께 남아 있어야 합니다. GenOS는 미리 등록한 정답(Ground Truth, 이하 GT)을 사용자 질문과 유사도로 검색해 응답에 함께 실어 보내는 방식으로 이를 제공합니다.

GT는 답변을 대체하지 않습니다. 사용자에게 전달되는 답변은 GT 연결 여부와 무관하게 기존 경로로 생성되며, GT는 채점용 정답을 함께 기록하는 역할만 합니다. 검증된 답변을 그대로 응답으로 사용하는 `FAQ Retriever`와는 다른 기능입니다.

GT 등록은 평가용 데이터셋(골든셋) 등록과 다른 단계입니다. GT는 정답 자체를 지식으로 적재하는 것이고, 그중 평가에 사용할 데이터를 지정하는 것이 골든셋입니다.

#### 1단계 · GT 파일 적재

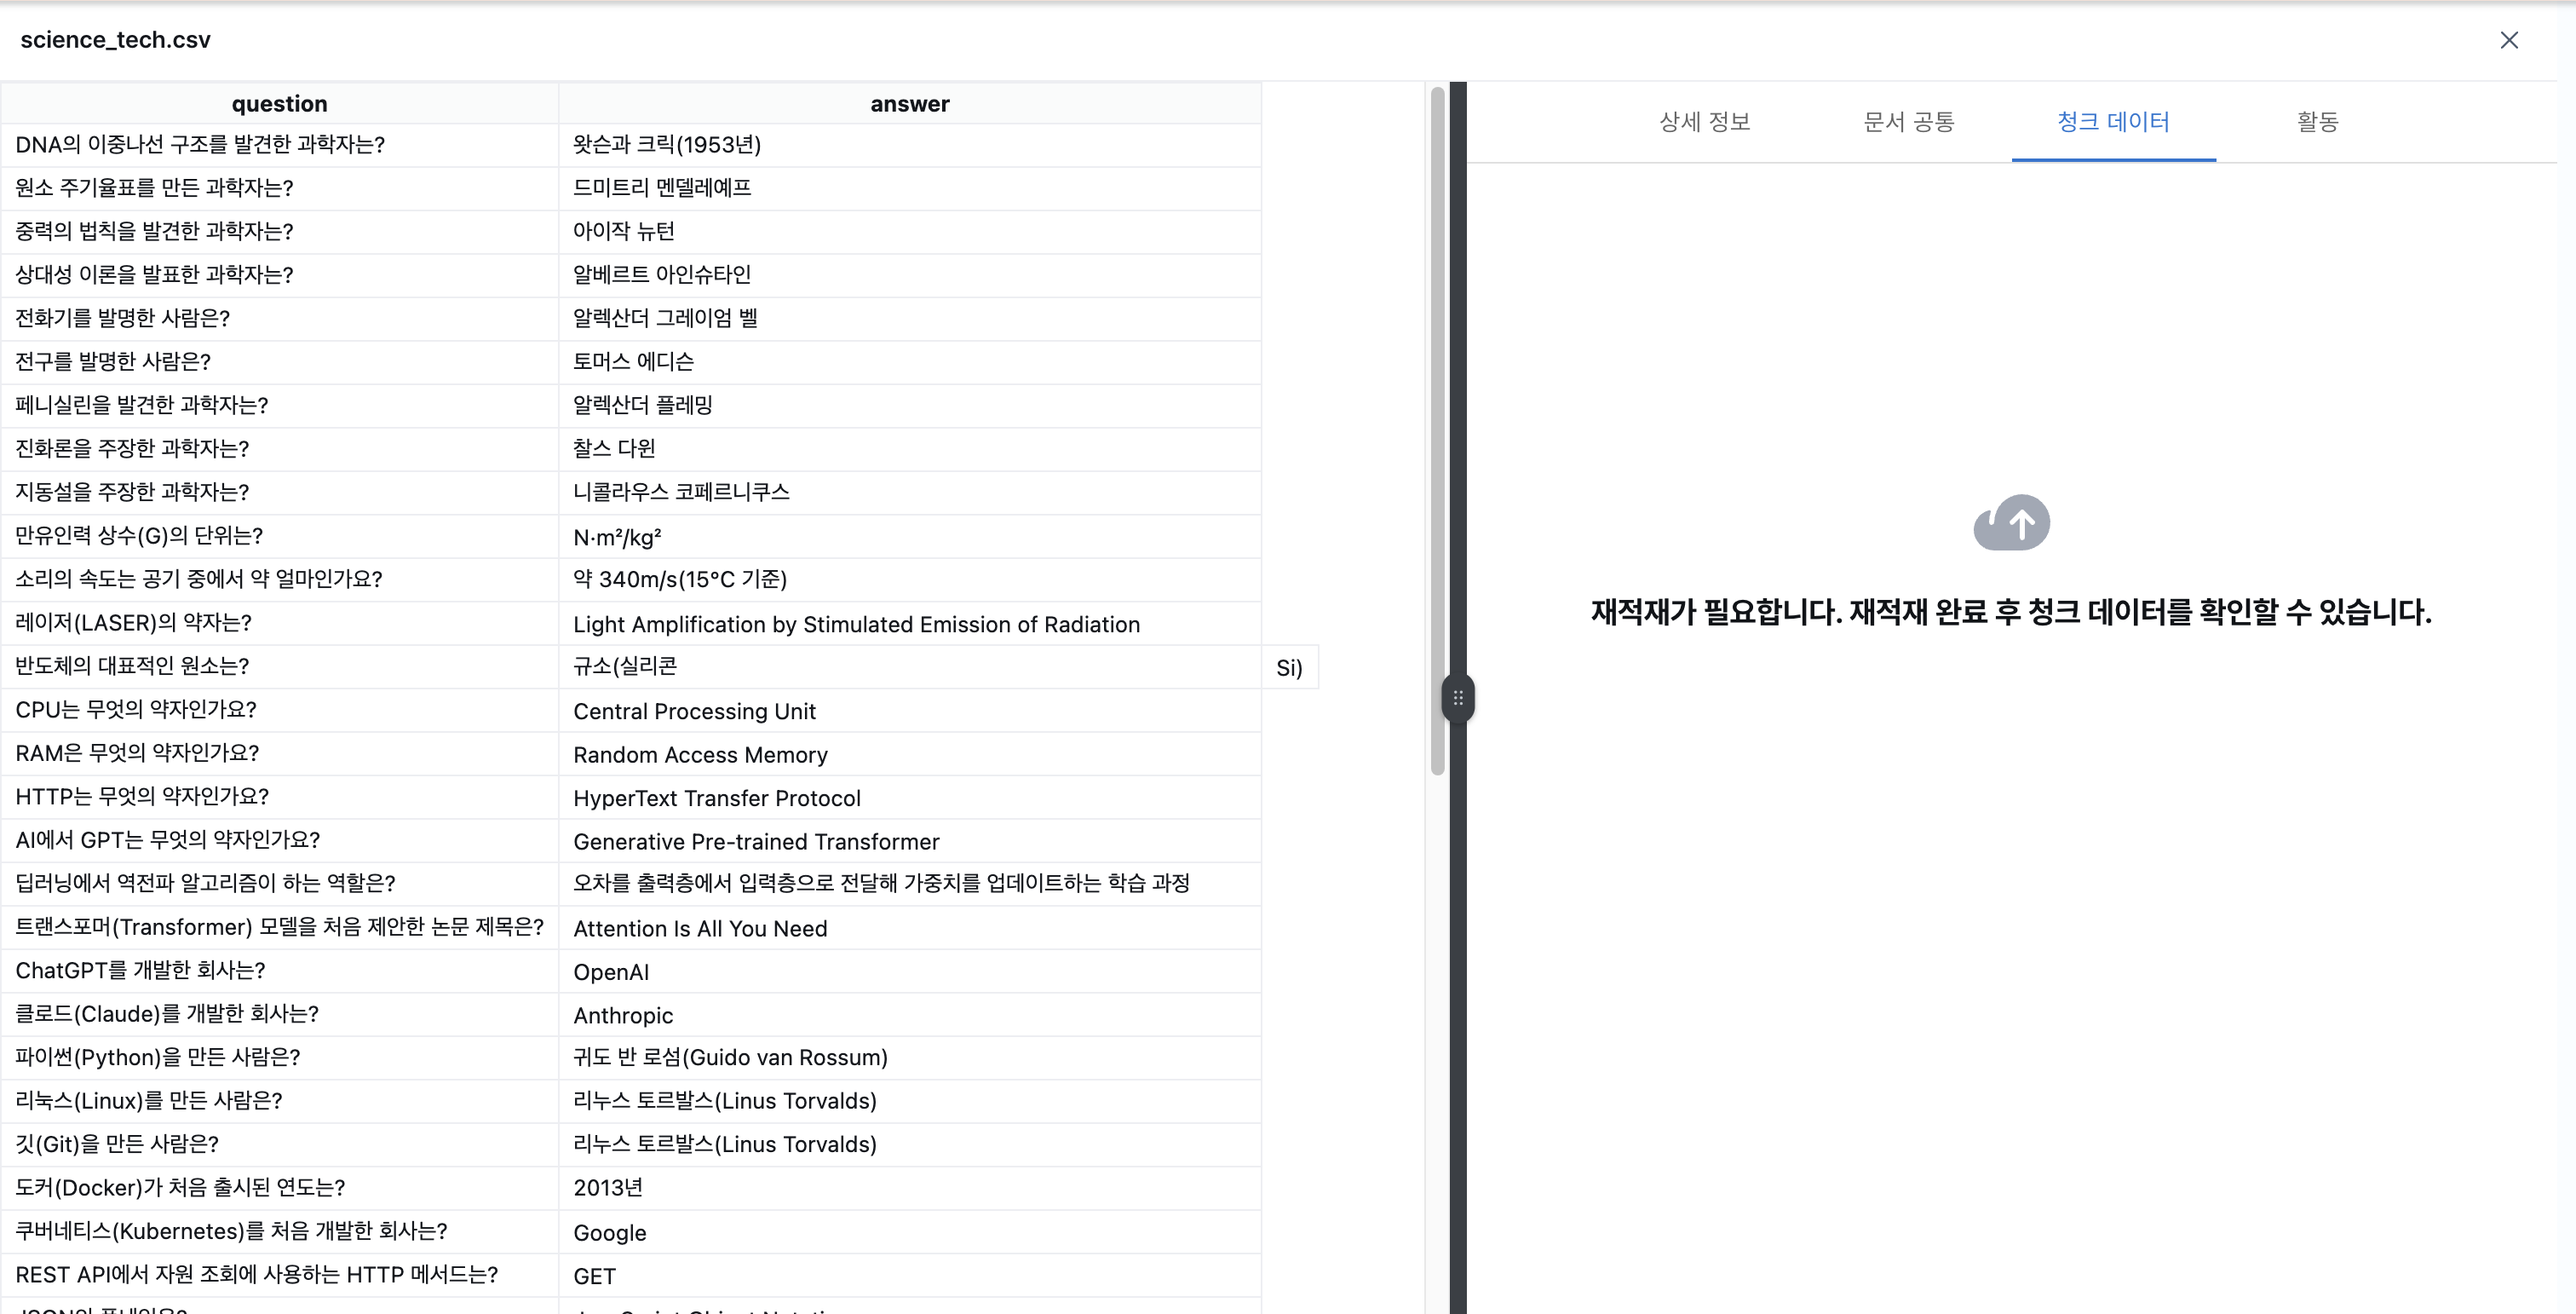
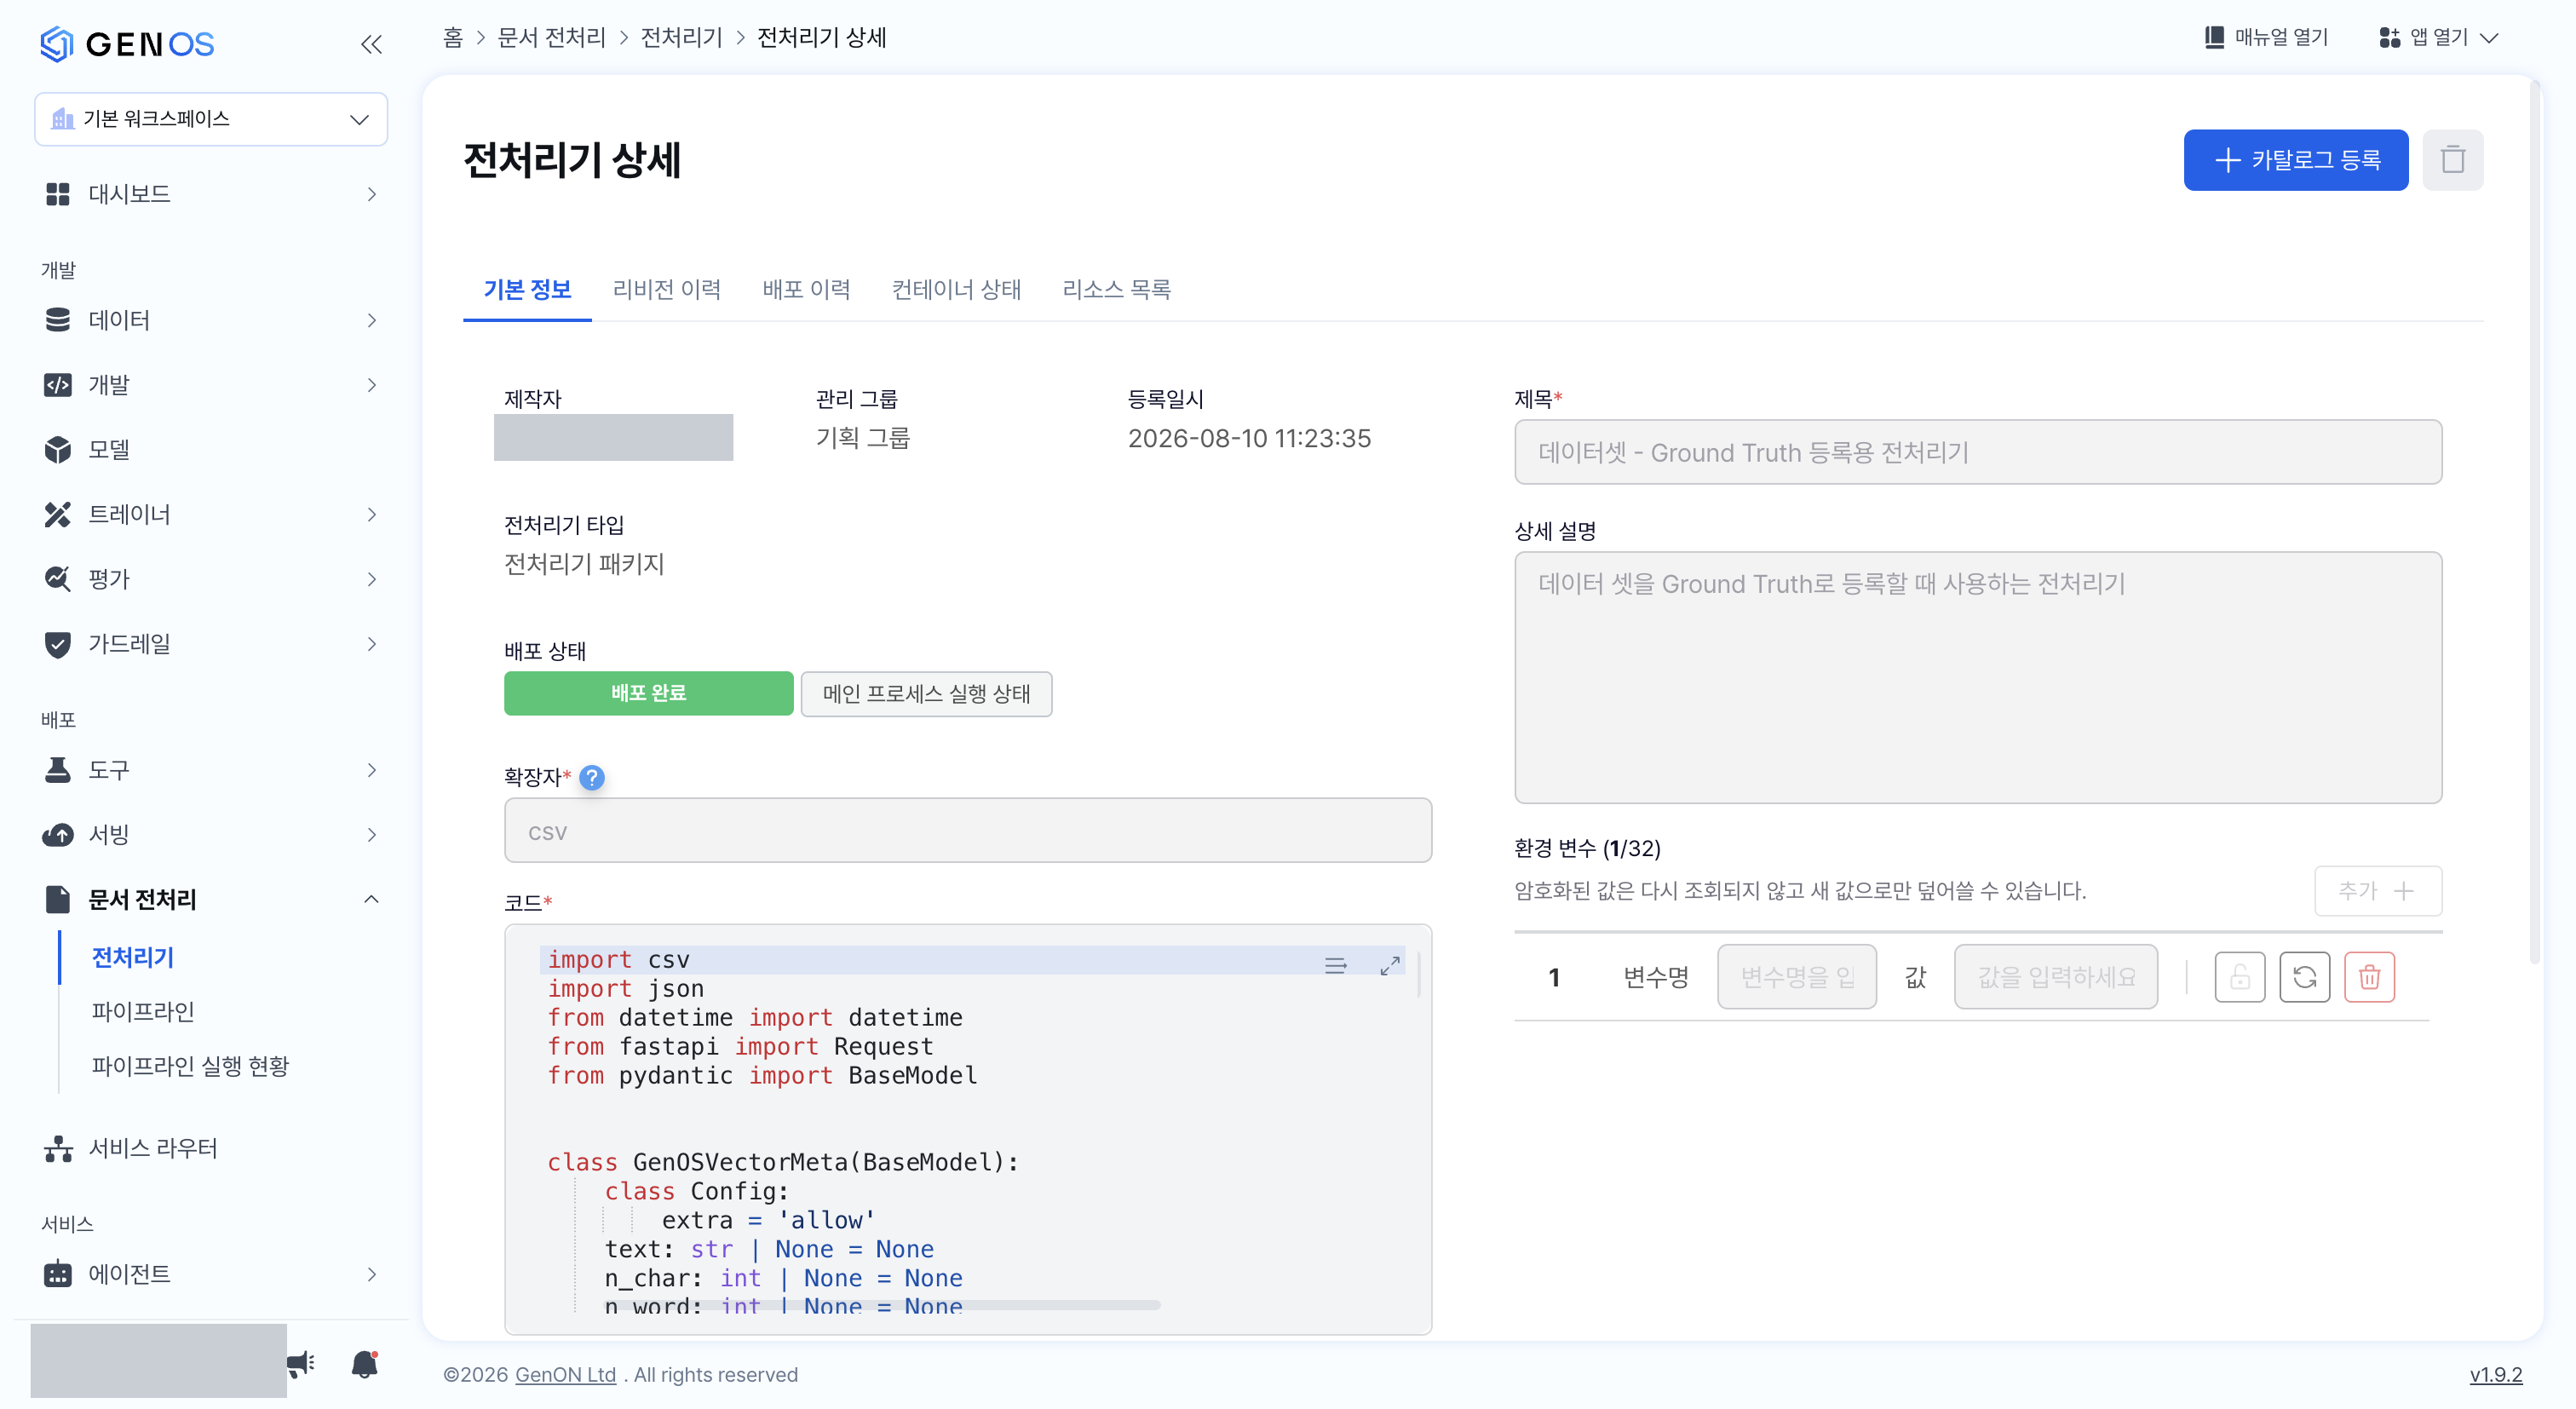
`question` · `answer` · `source` 컬럼으로 구성한 CSV를 준비하고, **문서 전처리**에 등록된 GT 전용 전처리기를 지정해 AI 드라이브에 업로드합니다. `source`는 선택 항목입니다.

<figure><img src="https://541419907-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FKhN1XWFV3oOVnFMMIHTE%2Fuploads%2Fgit-blob-b3fc5d13ee4eeebc8d27e1b742b651963b82b352%2Fmetric193_09_gt-csv-format.png?alt=media" alt="GT로 사용할 CSV 파일 — question · answer 컬럼"><figcaption><p>GT로 사용할 CSV 파일 — question · answer 컬럼</p></figcaption></figure>

* 한 행이 질문 1건과 그에 대한 정답 1건입니다. `question`이 비어 있는 행은 건너뛰며, 유효한 행이 하나도 없으면 적재가 실패합니다.
* `answer` 값에 쉼표가 포함되면 컬럼이 분리되므로 따옴표로 묶습니다.
* 평가 대상 워크플로우가 답변하는 범위의 질문으로 구성합니다. 대응되는 GT가 없는 질문은 채점 대상에서 제외해야 합니다(4단계 참고).

<figure><img src="https://541419907-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FKhN1XWFV3oOVnFMMIHTE%2Fuploads%2Fgit-blob-8566494c2054837a553d08126fcae179e6623a1b%2Fmetric193_10_gt-preprocessor.png?alt=media" alt="Ground Truth 등록용 전처리기 상세"><figcaption><p>Ground Truth 등록용 전처리기 상세</p></figcaption></figure>

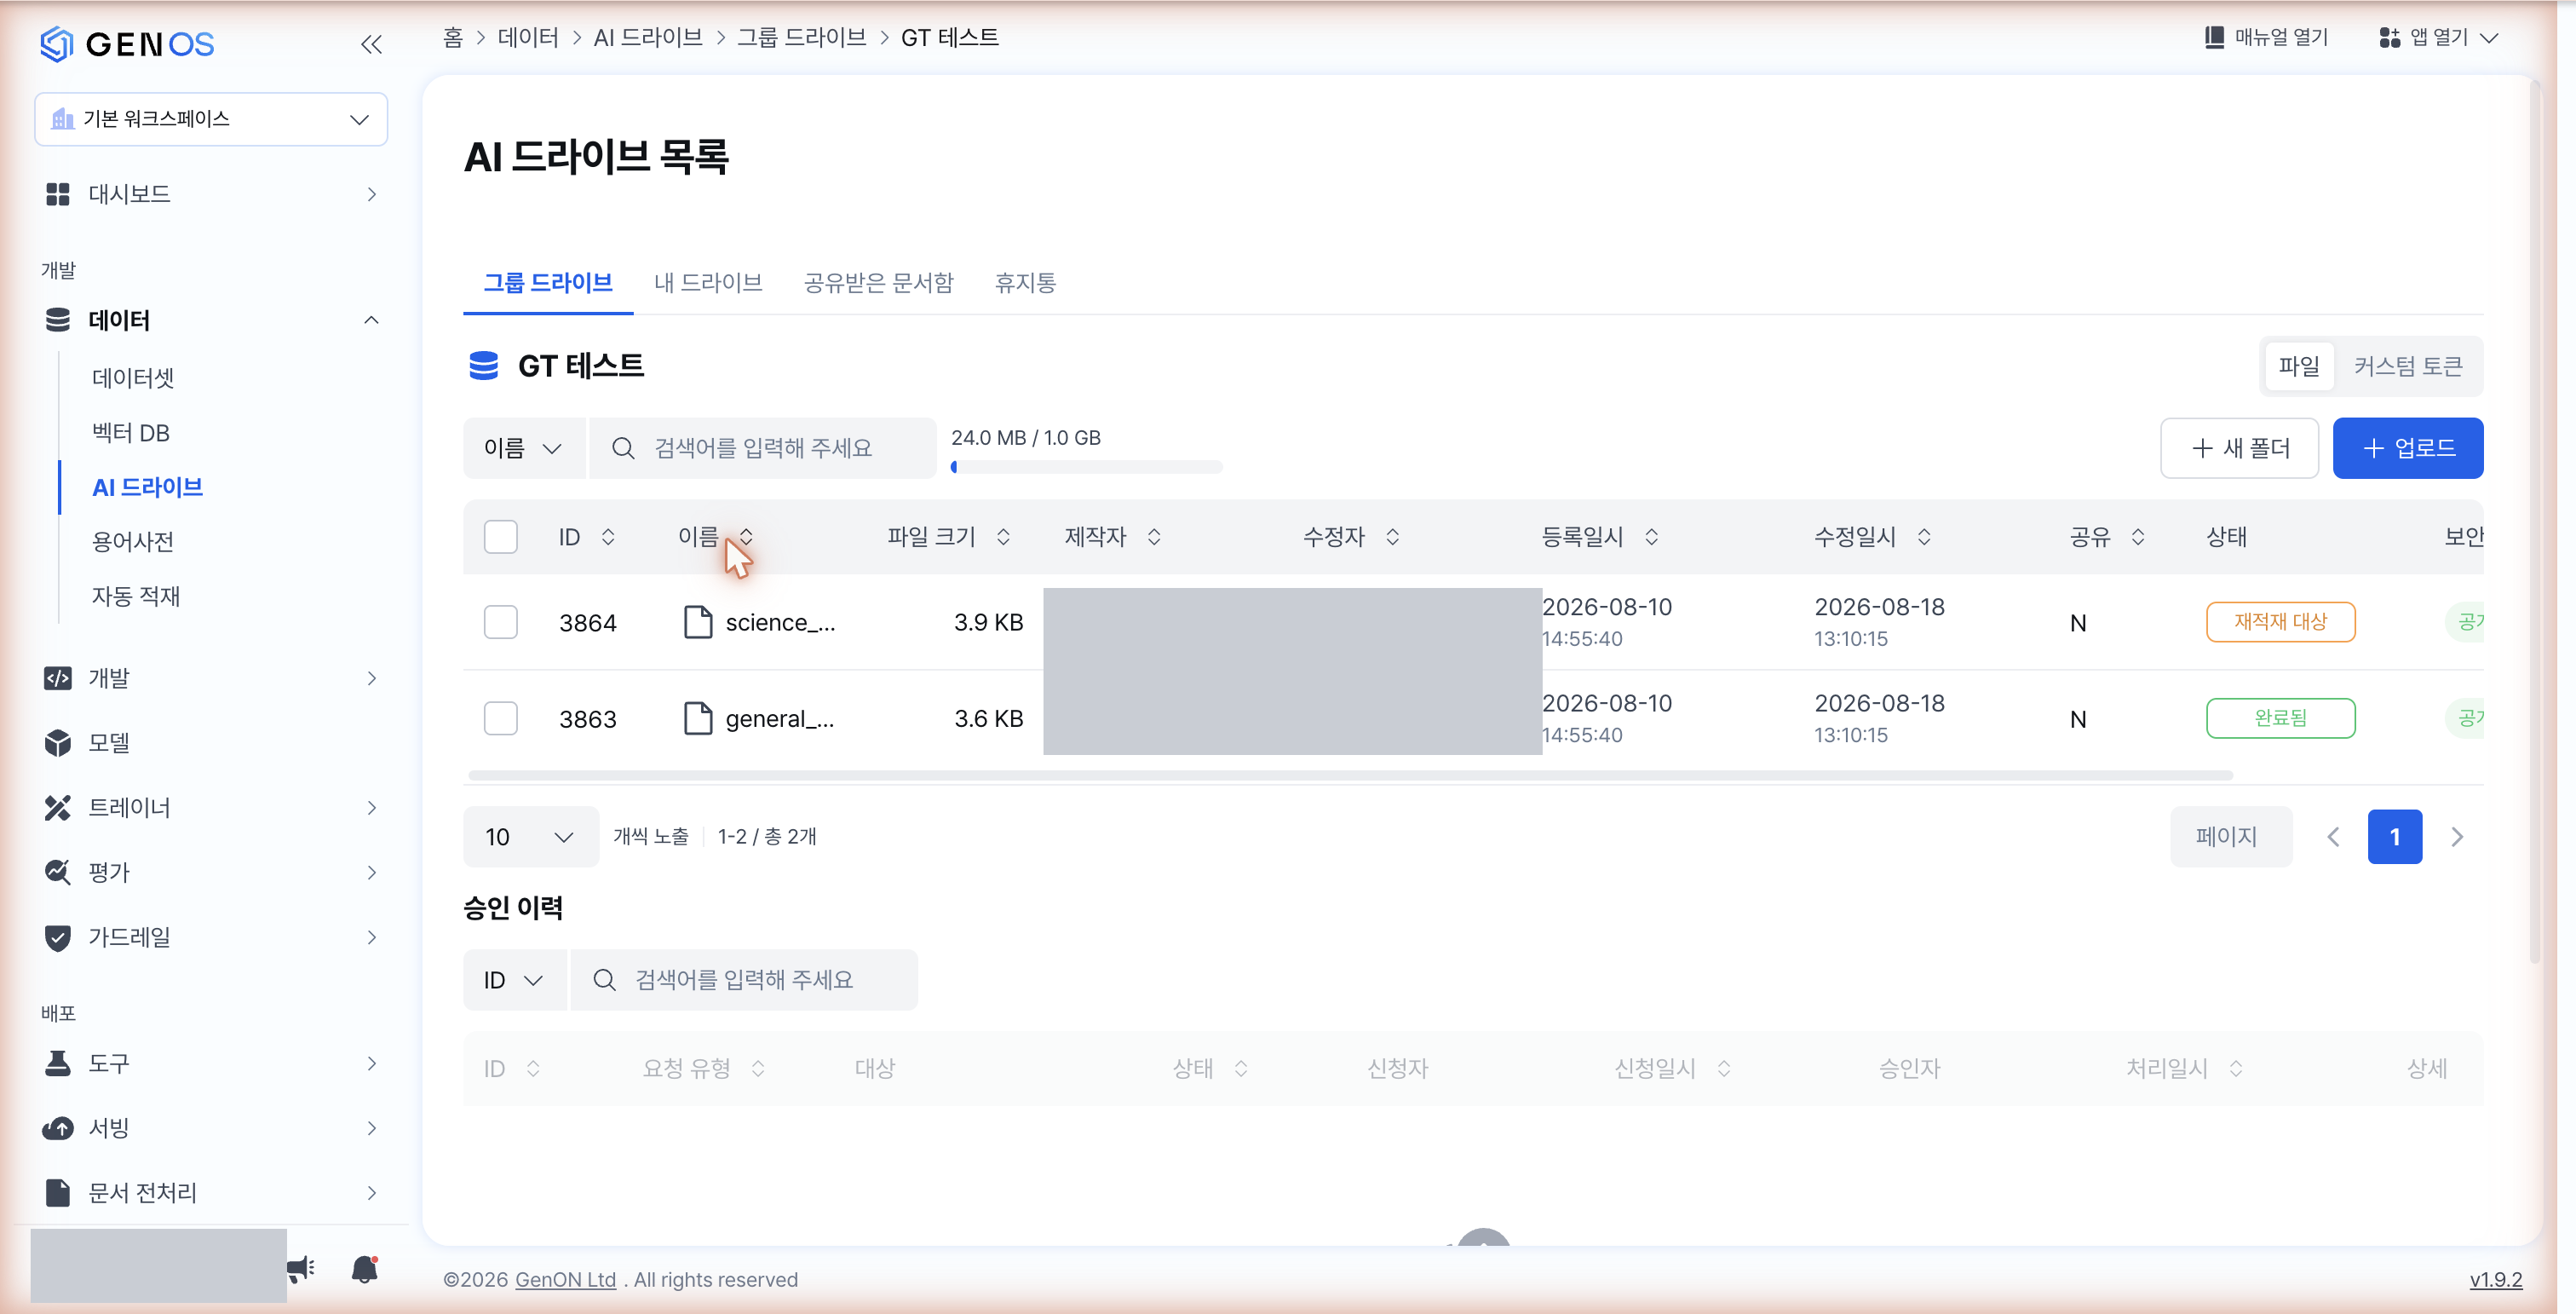
업로드한 파일은 AI 드라이브 목록에서 적재 상태와 함께 확인합니다.

<figure><img src="https://541419907-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FKhN1XWFV3oOVnFMMIHTE%2Fuploads%2Fgit-blob-791bc9355ce625ece45e45788d55c05895752820%2Fmetric193_11_gt-drive-upload.png?alt=media" alt="GT 파일을 업로드한 AI 드라이브"><figcaption><p>GT 파일을 업로드한 AI 드라이브</p></figcaption></figure>

적재된 청크의 텍스트는 질문 뒤에 `[ANSWER] 정답`, `[SOURCE] 출처`가 덧붙는 형태입니다. 파일 상세의 청크 데이터에서 확인할 수 있습니다.

#### 2단계 · 워크플로우 리비전에 연결

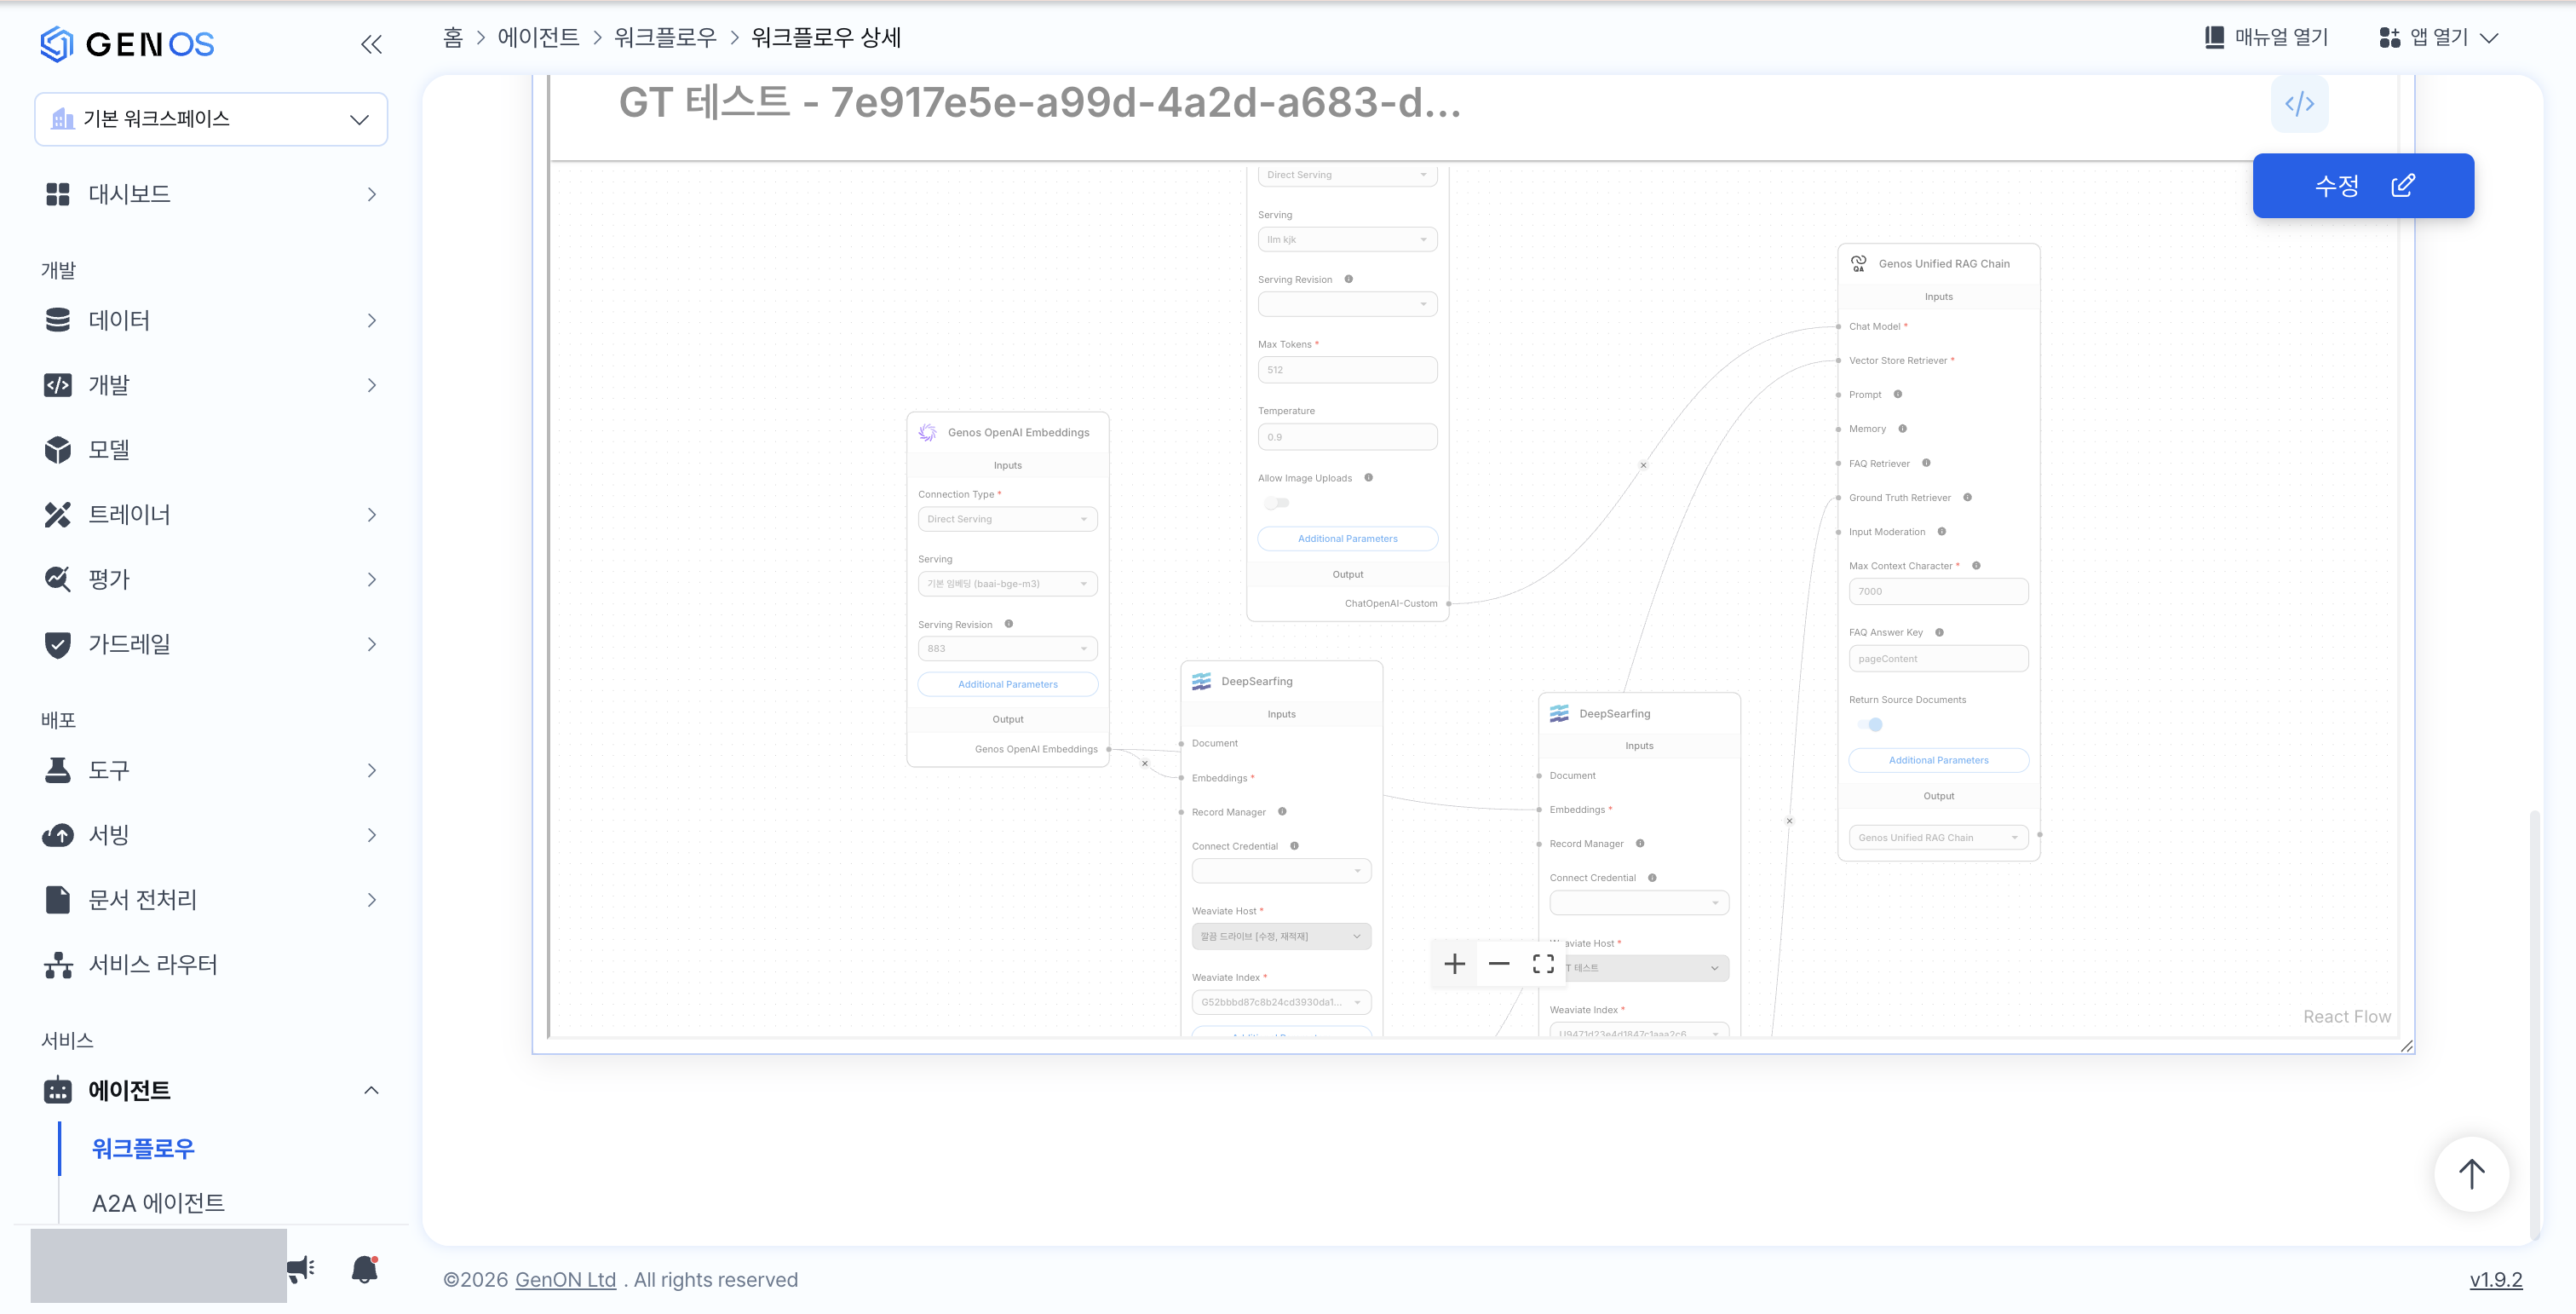
GT 파일을 올린 AI 드라이브를 워크플로우 리비전 구성에서 연결합니다. 일반 문서 검색용 연결은 그대로 두고 GT용 연결을 추가합니다.

* chatflow — Vector Stores 노드를 하나 더 추가해 GT 파일이 있는 AI 드라이브를 지정하고, 출력 Retriever를 `Mnc Unified RAG Chain`의 `Ground Truth Retriever` 입력에 연결합니다. 기존 문서 검색용 Retriever는 `Vector Store Retriever` 입력에 그대로 유지합니다.

<figure><img src="https://541419907-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FKhN1XWFV3oOVnFMMIHTE%2Fuploads%2Fgit-blob-5c5b445db0fef4a8a0d569b2451605d4218af872%2Fmetric193_13_gt-chatflow-connect.png?alt=media" alt="chatflow — 문서 검색용과 GT용 Retriever를 각각 연결"><figcaption><p>chatflow — 문서 검색용과 GT용 Retriever를 각각 연결</p></figcaption></figure>

* agentflow — Agent 노드의 지식(Vector Store)에 GT 드라이브를 추가하고 `Use as Ground Truth` 토글을 활성화합니다. 이 토글을 켠 지식은 모델의 도구 목록에서 제외되므로 답변 생성에는 사용되지 않습니다.

<figure><img src="https://541419907-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FKhN1XWFV3oOVnFMMIHTE%2Fuploads%2Fgit-blob-4be7c6912319c93dc5439731b55cc16f83c7821f%2Fmetric193_14_gt-agentflow-toggle.png?alt=media" alt="agentflow — Agent 노드 지식의 Use as Ground Truth 토글"><figcaption><p>agentflow — Agent 노드 지식의 Use as Ground Truth 토글</p></figcaption></figure>

#### 3단계 · 동작

사용자 질문이 들어오면 GT에서 유사한 질문을 검색하고, 해당 질문에 미리 입력된 정답을 응답의 `metadata.sourceDocuments`에 실어 트레이스에 남깁니다. 검색은 유사도 기반이므로 완전히 같은 문장이 아니어도 매칭됩니다.

#### 4단계 · 평가 기준에서 정답 변수 매핑

평가 기준 생성·수정 모달의 Variable mapping에서 정답 변수와 답변 변수를 다음과 같이 지정합니다.

| 변수                           | Object Field | JsonPath                          |
| ---------------------------- | ------------ | --------------------------------- |
| 정답 변수(예: `{{ground_truth}}`) | Output       | `$.data.metadata.sourceDocuments` |
| 답변 변수(예: `{{answer}}`)       | Output       | `$.data.text`                     |

`Preview` 토글을 켜서 실제 샘플에 정답 값이 채워지는지 확인한 뒤 저장합니다.

<figure><img src="https://541419907-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FKhN1XWFV3oOVnFMMIHTE%2Fuploads%2Fgit-blob-162967e63b5c9c7558cd216fbc2b092a8c0fa55d%2Fmetric193_15_gt-variable-mapping.png?alt=media" alt="Variable mapping — 정답 변수를 &#x60;$.data.metadata.sourceDocuments&#x60; 로 지정"><figcaption><p>Variable mapping — 정답 변수를 `$.data.metadata.sourceDocuments` 로 지정</p></figcaption></figure>

유의 사항

* 대응되는 GT가 없는 질문은 정답 변수가 **빈 값으로 들어가도 점수가 산출**됩니다. 평가 기준 Filter에 `Metadata` 조건을 추가해 정답이 실린 요청만 평가 대상으로 좁히는 것을 권장합니다.
* GT 검색은 유사도 기반이므로 관련이 낮은 질문에 다른 정답이 매칭될 수 있습니다. 이 경우 답변 품질이 아니라 평가 점수가 잘못 산출되므로, 점수가 비정상적으로 낮게 나오면 Filter 프리뷰의 Metadata 컬럼에서 매칭된 정답을 먼저 확인합니다.
* `Ground Truth Retriever`는 `FAQ Retriever`와 다릅니다. FAQ는 검증된 답변을 그대로 응답으로 사용하는 경로이고, GT는 평가용 정답을 함께 실어 보내기만 합니다.
* 워크플로우 리비전을 변경하면 GT 연결이 누락될 수 있습니다. 리비전 변경 후 GT 연결과 Variable mapping을 함께 확인합니다.

### 워크플로우 이용 로그

**에이전트 > 워크플로우 > 워크플로우 상세 > 이용 로그** 탭에서 워크플로우가 처리한 요청 이력을 확인하고, 이 워크플로우에 적용할 평가 기준을 관리합니다.

탭 상단에는 조회 기간(시작일 \~ 종료일), 우측에 **평가 기준** 선택 드롭다운과 **\[평가 기준 설정]** 버튼이 있습니다. 그 아래 검색(요청 ID 등), 새로고침, \*\*\[파일 다운로드]\*\*가 제공됩니다.

<figure><img src="https://541419907-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FKhN1XWFV3oOVnFMMIHTE%2Fuploads%2Fgit-blob-60452e59dec44df4c32ac9043b4a85a01899a3a8%2Fmetric193_06_usage-log-tab.png?alt=media" alt="이용 로그 탭 — 활성 평가 기준 0건일 때의 경고와 기본 컬럼"><figcaption><p>이용 로그 탭 — 활성 평가 기준 0건일 때의 경고와 기본 컬럼</p></figcaption></figure>

로그 표의 기본 컬럼은 다음과 같습니다.

| 컬럼     | 설명                |
| ------ | ----------------- |
| 요청 ID  | 요청 단위 식별자         |
| POD ID | 요청을 처리한 워크플로우 POD |
| IP     | 호출 IP             |
| 세션 ID  | 대화·실행 세션 식별자      |
| 등록일시   | 요청 등록일시           |
| 소요시간   | 처리 소요시간(초)        |
| 결과     | `Success` 등 처리 결과 |

#### 평가점수 컬럼

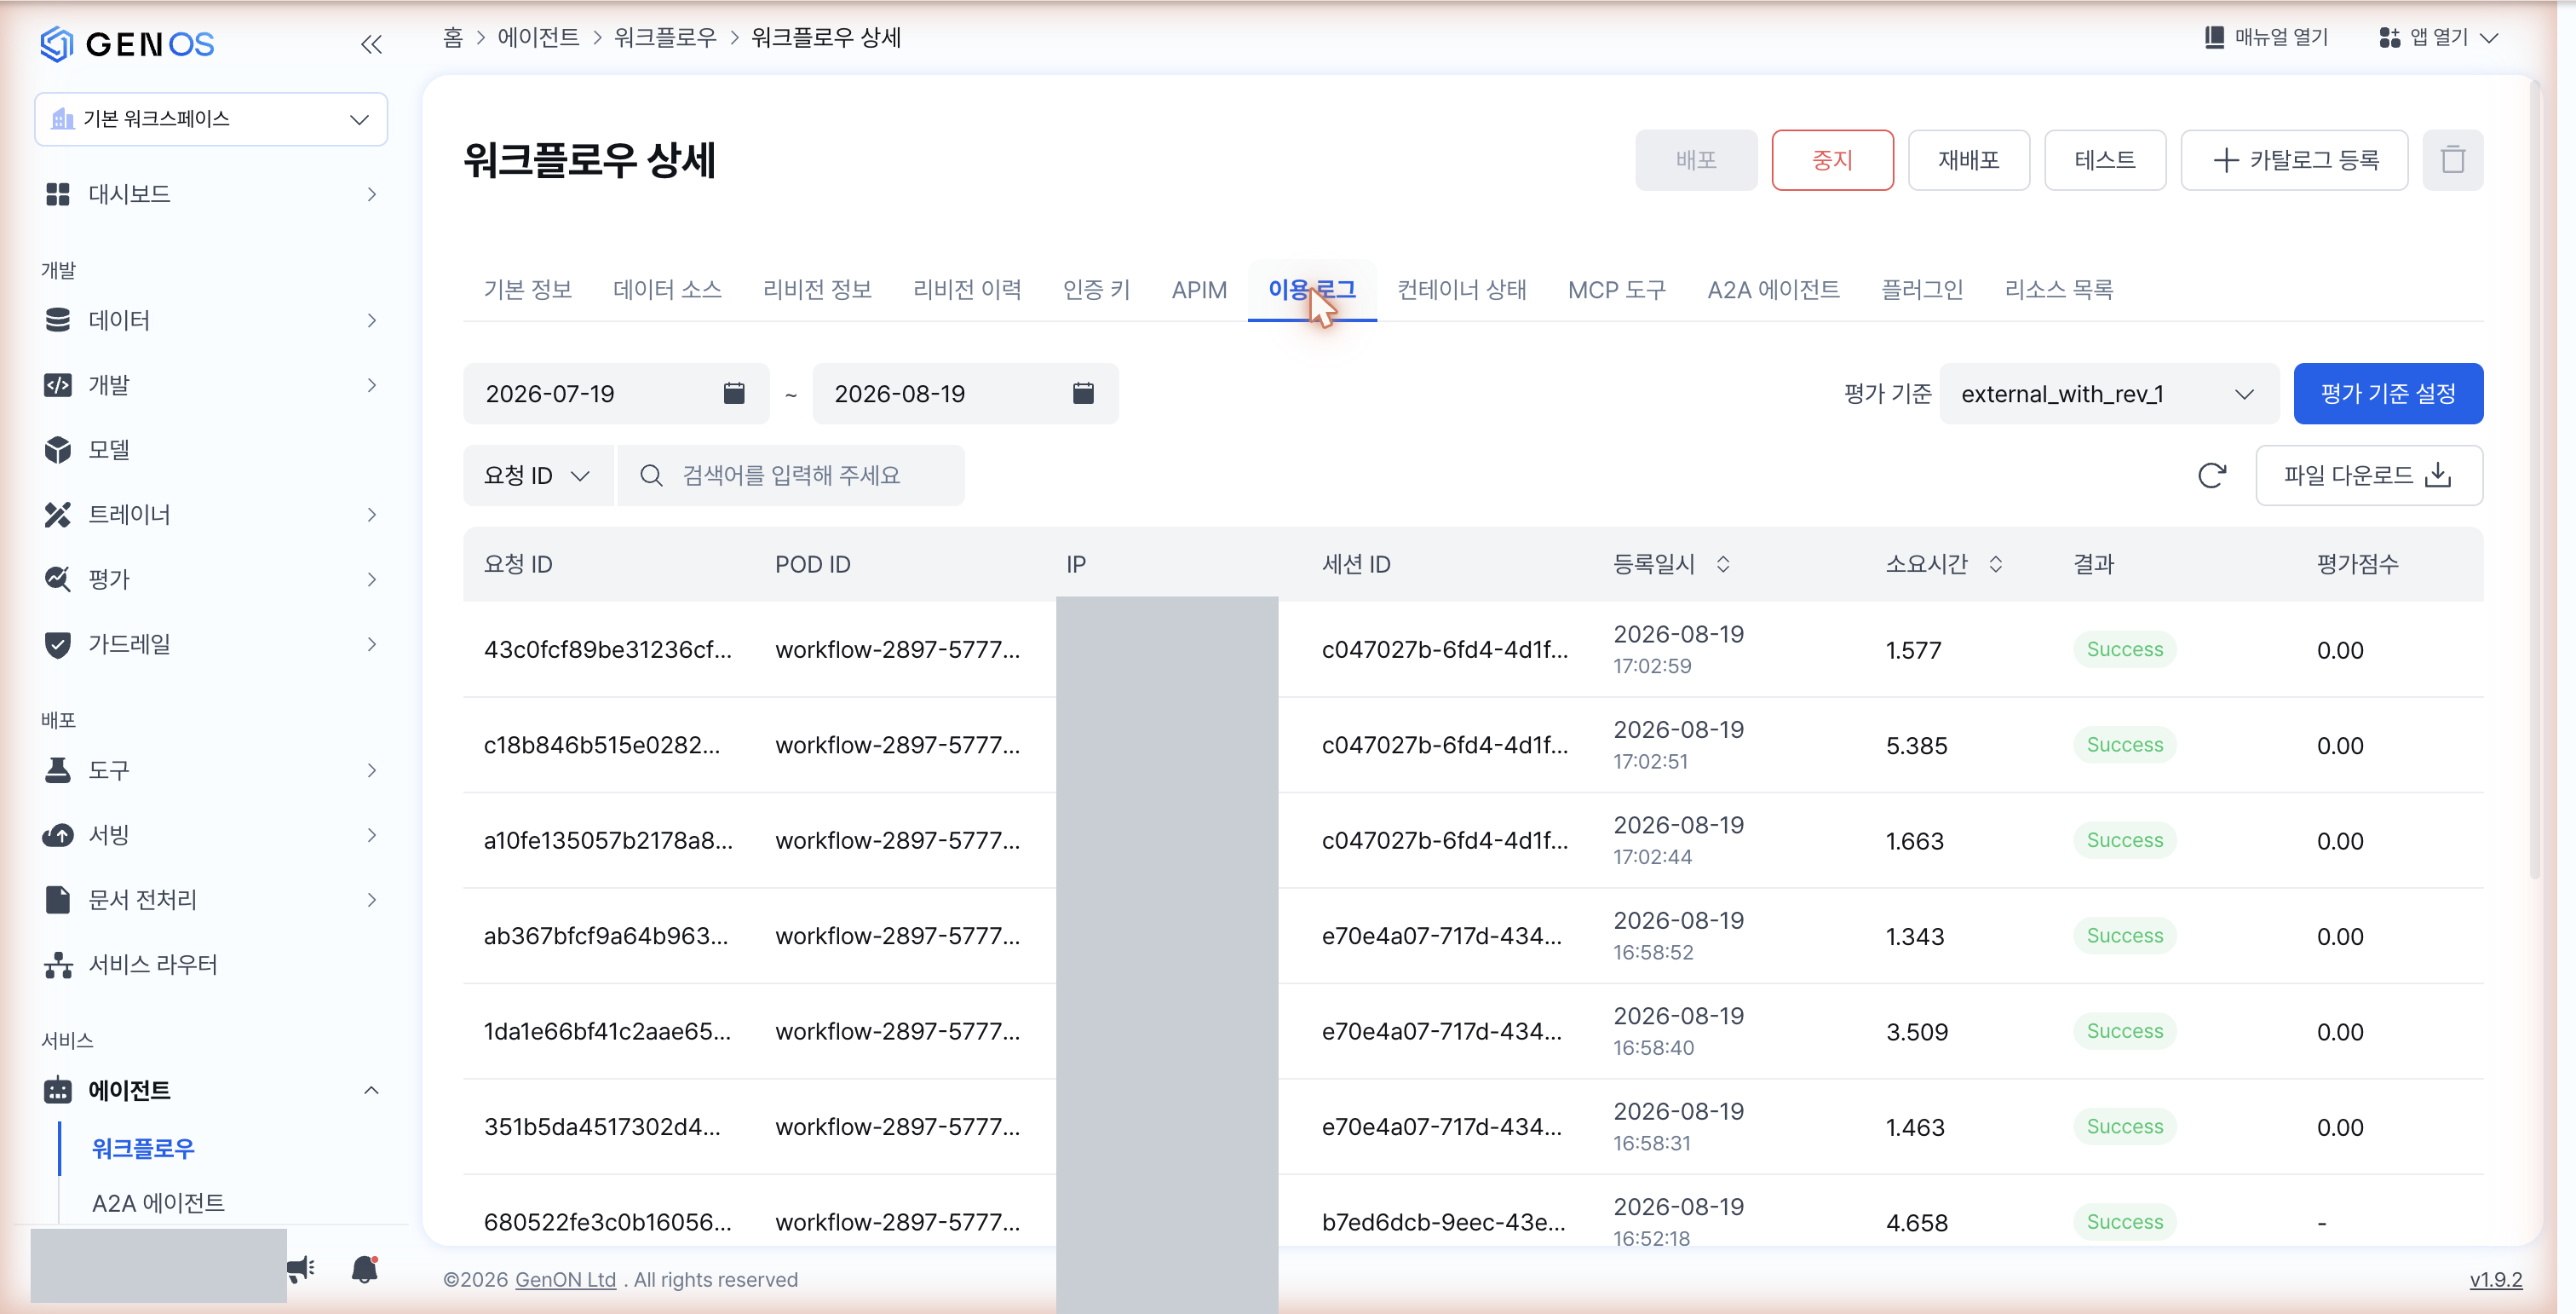
활성 상태인 평가 기준이 **하나 이상** 있을 때만 `평가점수` 컬럼이 추가됩니다. 상단 **평가 기준** 드롭다운에서 활성 기준 중 하나를 고르면, 그 기준으로 채점된 점수가 해당 컬럼에 표시됩니다.

활성 기준이 하나도 없으면 컬럼 자체가 표시되지 않고, 대신 상단에 다음 경고가 표시됩니다.

> 활성 상태인 평가 기준이 없어 평가 점수가 집계되지 않습니다.

평가점수는 정렬을 지원하지 않습니다.

### 평가 기준 설정

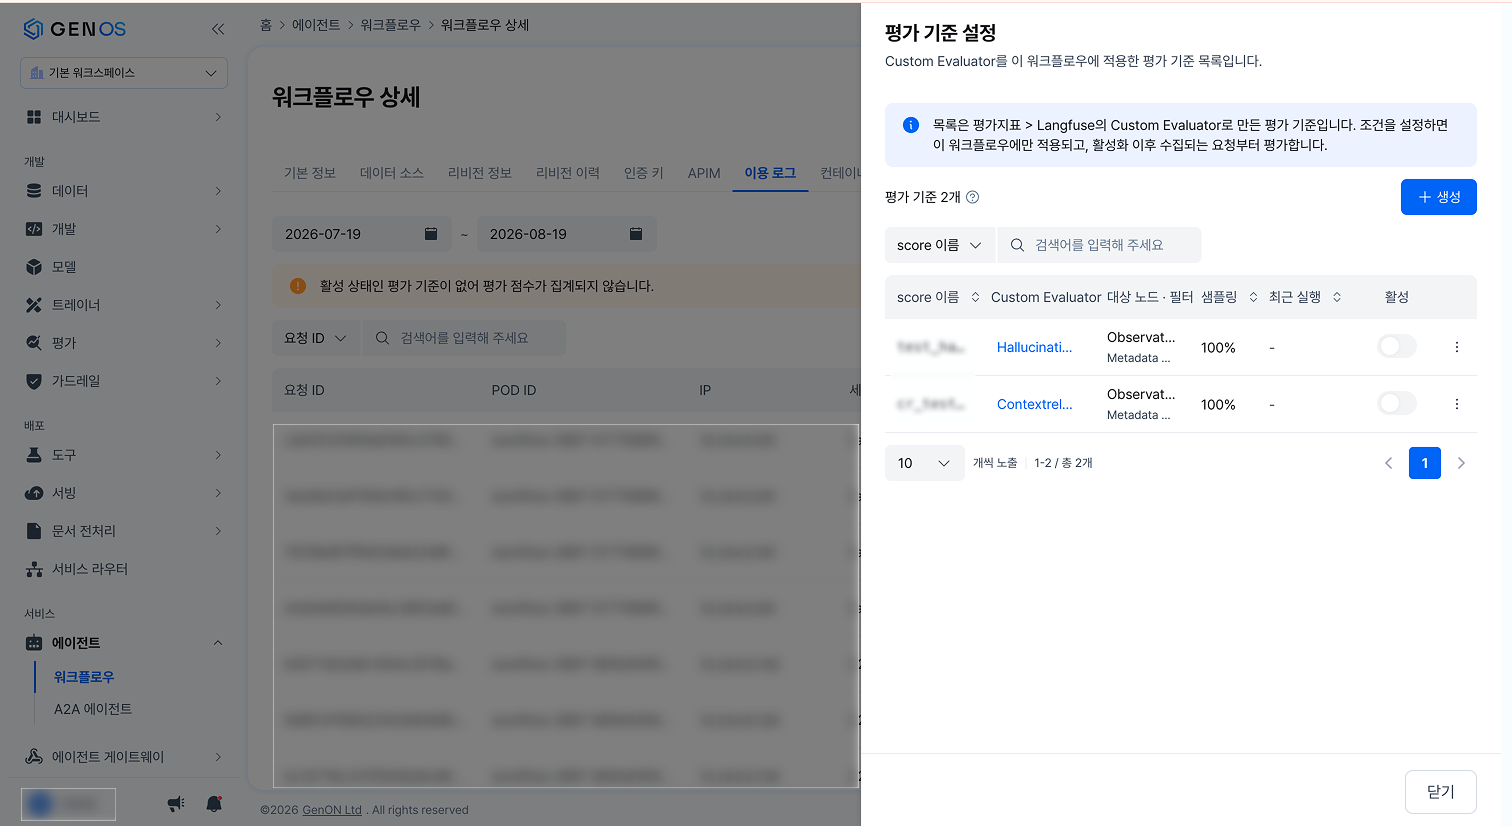
이용 로그 탭의 \*\*\[평가 기준 설정]\*\*을 누르면 우측에서 사이드 패널이 열립니다. 패널 상단에는 "Custom Evaluator를 이 워크플로우에 적용한 평가 기준 목록입니다." 설명과 함께 다음 안내가 표시됩니다.

> 목록은 평가지표 > Langfuse의 Custom Evaluator로 만든 평가 기준입니다. 조건을 설정하면 이 워크플로우에만 적용되고, 활성화 이후 수집되는 요청부터 평가합니다.

<figure><img src="https://541419907-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FKhN1XWFV3oOVnFMMIHTE%2Fuploads%2Fgit-blob-527739e3598386ac7ef0373cf2044c45105b6c91%2Fmetric193_07_eval-rule-panel.png?alt=media" alt="평가 기준 설정 사이드 패널 — 목록·활성 토글"><figcaption><p>평가 기준 설정 사이드 패널 — 목록·활성 토글</p></figcaption></figure>

그 아래 `평가 기준 N개`와 **\[생성]** 버튼, score 이름 기준 검색이 있고, 목록은 다음 컬럼으로 구성됩니다.

| 컬럼               | 설명                                   |
| ---------------- | ------------------------------------ |
| score 이름         | 트레이스에 남는 score 이름                    |
| Custom Evaluator | 적용한 Evaluator. 클릭하면 Evaluator 상세로 이동 |
| 대상 노드 · 필터       | 평가 대상 범위와 적용된 필터 요약                  |
| 샘플링              | 평가 비율(%)                             |
| 최근 실행            | 마지막 평가 실행 시각. 실행 이력이 없으면 `-`         |
| 활성               | 활성/비활성 토글                            |

Custom Evaluator 하나로 조건이 다른 평가 기준을 여러 개 만들 수 있으며, **최대 50개까지 활성화**할 수 있습니다. 활성 토글을 바꾸면 이용 로그의 평가 기준 드롭다운과 평가점수 컬럼에 즉시 반영됩니다.

평가 기준이 없으면 "설정된 평가 기준이 없습니다." + "\[생성]에서 Custom Evaluator를 선택하고 적용 조건을 지정해 주세요." 안내가, 검색 결과가 없으면 "조건에 맞는 평가 기준이 없습니다."가 표시됩니다.

읽기 권한만 있는 사용자에게는 **\[생성]** 버튼과 행 액션이 표시되지 않습니다(비활성 회색 처리가 아니라 아예 노출되지 않습니다). 활성 토글은 현재 상태를 보여주기 위해 표시되지만 조작할 수 없습니다.

### 평가 기준 생성·수정

패널의 \*\*\[생성]\*\*을 누르면 **평가 기준 생성** 모달이 열립니다. 상단에 "이 워크플로우에만 적용되는 조건입니다. 저장하면 이후 수집되는 요청부터 반영됩니다."가 안내됩니다.

<figure><img src="https://541419907-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FKhN1XWFV3oOVnFMMIHTE%2Fuploads%2Fgit-blob-17633b113496b8e7d9ae50adb6d53086124a4f33%2Fmetric193_08_eval-rule-create-modal.png?alt=media" alt="평가 기준 생성 모달 — 대상 노드·Filter·필터 프리뷰·Sampling"><figcaption><p>평가 기준 생성 모달 — 대상 노드·Filter·필터 프리뷰·Sampling</p></figcaption></figure>

| 입력 항목            | 필수 | 설명                                         |
| ---------------- | -- | ------------------------------------------ |
| Custom Evaluator | 필수 | 평가지표 > Langfuse에 등록된 템플릿에서 선택              |
| score 이름         | 필수 | 최대 64자. 이 워크플로우에서 트레이스에 남길 score 이름        |
| 대상 노드            | 선택 | 평가 대상 범위 프리셋                               |
| Filter           | 선택 | 평가 대상을 좁히는 조건. 조건을 모두 만족하는 observation만 평가 |
| Sampling         | 필수 | 조건에 맞는 트레이스 중 평가할 비율(%)                    |
| Variable mapping | —  | 평가 프롬프트 변수에 트레이스의 어떤 값을 넣을지 지정             |

`score 이름`은 **영문 소문자 · 숫자 · 언더스코어(`_`)만** 사용할 수 있고, 같은 워크플로우에서 이미 쓰고 있는 이름은 사용할 수 없습니다. 자동 입력은 제공되지 않으므로 항상 직접 입력합니다.

**\[생성]** 버튼은 입력을 하나라도 변경하면 활성화됩니다(필수 항목 충족 여부와 무관). 누르면 전체 검증이 수행되고, 문제가 있으면 첫 오류 위치로 화면이 이동합니다. 저장하지 않고 닫으려 하면 "저장하지 않고 나가시겠습니까?" 확인을 거칩니다.

#### 대상 노드

다음 4개 중에서 선택합니다.

| 선택값    | 평가 대상                      |
| ------ | -------------------------- |
| 선택 안 함 | 프리셋을 쓰지 않고 Filter로만 대상을 지정 |
| 대화 전체  | 워크플로우 실행 트레이스 전체           |
| 문서 검색  | 문서 검색(retriever) 단계        |
| 모델 응답  | 모델 응답 생성 단계                |

프리셋을 고르면 그에 해당하는 조건이 Filter 목록 **맨 앞에 자동으로 추가**됩니다. 자동 추가된 조건도 일반 조건과 똑같이 직접 삭제·수정할 수 있고, 프리셋을 바꾸면 이전 자동 조건은 교체됩니다.

#### Filter

`Where` 행에 필드 · 연산자 · 값을 지정하고, \*\*\[필터 추가]\*\*로 조건을 덧붙입니다(두 번째 행부터는 `And`). 조건은 **최대 10개**까지 추가할 수 있고, 상한에 도달하면 추가 버튼이 비활성화되며 "최대 10개까지 추가할 수 있습니다." 안내가 표시됩니다.

사용할 수 있는 필드는 다음 10종입니다.

| 필드                               | 연산자                                                                 | 값 입력 방식                          |
| -------------------------------- | ------------------------------------------------------------------- | -------------------------------- |
| Type · Name · Level · Trace Name | `any of` / `none of`                                                | 다중 선택                            |
| Tags                             | `any of` / `none of` / `all of`                                     | 다중 선택 (후보 값이 없으면 필드 자체가 표시되지 않음) |
| Version · User ID · Session ID   | `=` / `contains` / `does not contain` / `starts with` / `ends with` | 텍스트 입력                           |
| Metadata                         | `=` / `contains` / `does not contain` / `starts with` / `ends with` | key 입력 + 값 입력                    |
| Tool Call Count                  | `=`                                                                 | 숫자 입력                            |

연산자 목록은 선택한 필드에 따라 달라지고, 필드를 바꾸면 연산자와 값은 초기화됩니다.

GenOS 워크플로우 트레이스에서 `Type`으로 실제 기록되는 값은 `GENERATION`(LLM 호출) · `SPAN`(일반 스팬) · `EMBEDDING`(임베딩 호출) 3종입니다.

조건을 입력하면 그 아래에 **"필터에 해당하는 최근 1개월 샘플 · N건"** 프리뷰가 표시됩니다. Start Time · Type · Name · Input · Output · Metadata 컬럼으로 실제 걸리는 요청을 미리 확인할 수 있어, 저장 전에 조건이 의도한 대상을 잡는지 검증할 수 있습니다. 해당 요청이 없으면 "조건에 맞는 요청이 없습니다."로 표시됩니다.

#### Sampling

슬라이더 또는 숫자 입력으로 0\~100% 사이 값을 지정합니다. 100%면 조건에 맞는 트레이스를 모두 평가하고, 70%면 새로 쌓이는 트레이스가 평가될 확률이 70%입니다.

#### Variable mapping

선택한 Custom Evaluator의 평가 프롬프트에 정의된 변수 목록이 카드로 표시되고, 각 변수에 트레이스의 어떤 값을 넣을지(Object Field, 필요 시 JsonPath) 지정합니다. `Preview` 토글을 켜면 실제 샘플에 매핑을 적용한 결과를 확인할 수 있고, 좌우 화살표로 샘플을 넘겨볼 수 있습니다. Evaluator를 선택하지 않았거나 변수가 없으면 "매핑할 항목이 없습니다"로 표시됩니다.

정답과 대조하는 Evaluator를 사용할 경우, 워크플로우에 GT를 먼저 연결해야 정답 변수를 매핑할 수 있습니다. `정답(Ground Truth) 기반 평가 준비`를 참고해 주세요.

#### 리비전 변경 주의

모달 하단에는 다음 경고가 상시 표시됩니다.

> 워크플로우 리비전을 변경하면 내부 노드 구성이 달라질 수 있습니다. 대상 노드·필터가 더 이상 맞지 않을 수 있으니 리비전 변경 후 평가 기준을 다시 확인해 주세요.

#### 수정·삭제

행 액션에서 수정하면 **평가 기준 설정** 모달이 기존 값으로 열립니다. score 이름은 표시용 이름만 변경되며, 트레이스 조회에 쓰이는 실제 키는 생성 시 발급된 값이 그대로 유지됩니다. 따라서 이름을 바꿔도 이미 쌓인 점수는 그대로 조회됩니다.

삭제는 **평가 기준 삭제** 재확인 모달에서 **해당 평가 기준의 score 이름을 입력**해야 실행됩니다. 값이 다르면 "입력한 값이 일치하지 않습니다."가 표시됩니다.

### API 호출 방식

관리자 화면이 사용하는 admin-api 엔드포인트입니다. 수정·삭제도 `POST`를 사용합니다(admin-api 관례).

| 메서드        | 경로                                         | 용도                                    |
| ---------- | ------------------------------------------ | ------------------------------------- |
| GET        | `/langfuse/eval/health`                    | Langfuse 서버 상태 확인                     |
| GET        | `/langfuse/eval/templates`                 | Custom Evaluator 목록 조회                |
| GET        | `/langfuse/eval/templates/selectable`      | 평가 기준 생성 시 선택 가능한 Evaluator 목록(변수 포함) |
| GET        | `/langfuse/eval/templates/prompt-examples` | 프롬프트 예시 목록                            |
| GET        | `/langfuse/eval/templates/{id}`            | Custom Evaluator 상세                   |
| POST       | `/langfuse/eval/templates`                 | Custom Evaluator 생성                   |
| POST       | `/langfuse/eval/templates/{id}/update`     | Custom Evaluator 수정                   |
| POST       | `/langfuse/eval/templates/{id}/delete`     | Custom Evaluator 삭제                   |
| GET        | `/langfuse/eval/templates/{id}/rules`      | 해당 Evaluator를 사용 중인 평가 기준 목록          |
| GET        | `/langfuse/eval/filter-options`            | Filter 필드 후보 값                        |
| POST       | `/langfuse/eval/filter-preview`            | Filter 조건에 해당하는 샘플 미리보기               |
| GET        | `/langfuse/eval/rules`                     | 평가 기준 목록(워크플로우 기준)                    |
| GET        | `/langfuse/eval/rules/{id}`                | 평가 기준 상세                              |
| POST       | `/langfuse/eval/rules`                     | 평가 기준 생성                              |
| POST       | `/langfuse/eval/rules/{id}/update`         | 평가 기준 수정·활성 토글                        |
| POST       | `/langfuse/eval/rules/{id}/delete`         | 평가 기준 삭제                              |
| GET · POST | `/langfuse/eval/default-model`             | 기본 판정 모델 조회·설정                        |

목록 조회는 `page` · `page_size` · `srch_field` · `srch_value` · `order_field` · `order_type` 파라미터를 사용합니다.

### 오류·예외 처리

| 코드         | 발생 상황                            | 화면 표시 문구                                       |
| ---------- | -------------------------------- | ---------------------------------------------- |
| `06020001` | Langfuse 서버 연결 실패 또는 상태 이상       | Langfuse 서버에 연결할 수 없습니다. 잠시 후 다시 시도해 주세요.      |
| `06020002` | 대상 Evaluator가 없거나 이미 삭제됨         | 평가 템플릿({template\_id})을 찾을 수 없습니다.             |
| `06020003` | 선택한 판정 모델 서빙에 활성 리비전이 없음         | 서빙({serving\_id})에 활성 revision이 없습니다.          |
| `06020004` | 사용 중인 평가 기준이 있는 Evaluator를 삭제 시도 | 평가 기준(Rule) {건수}건이 이 템플릿을 사용 중입니다. 먼저 삭제해 주세요. |
| `06020005` | Langfuse API가 오류 응답              | Langfuse API 오류 ({status}): {detail}           |
| `06020006` | 대상 평가 기준이 없거나 이미 삭제됨             | 평가 기준({rule\_id})을 찾을 수 없습니다.                  |

그 밖의 상황별 안내는 다음과 같습니다.

| 상황                      | 표시                                             |
| ----------------------- | ---------------------------------------------- |
| Evaluator 저장 실패(원인 불명)  | "Langfuse API 오류가 발생했습니다. 관리자에게 문의해주세요."       |
| Evaluator 상세 조회 실패      | "Evaluator 정보를 불러오지 못했습니다."                    |
| 평가 기준 목록 조회 실패          | "데이터를 가져올 수 없습니다. 페이지를 새로 고치거나 연결 상태를 확인해 주세요" |
| 평가 기준 생성·수정·삭제·활성 변경 실패 | "평가 기준 {생성/수정/삭제/활성 상태 변경}에 실패했습니다"            |
| 이미 삭제된 대상을 다시 삭제        | 실패 처리 후에도 목록을 재조회해 최신 상태로 갱신                   |

### 사용자 시나리오

#### 환각(hallucination) 여부를 상시 감시하려는 경우

평가 > 평가지표 > Langfuse에서 \*\*\[Custom Evaluator 생성]\*\*을 누르고, 프롬프트 예시에서 `Hallucination`을 선택해 평가 프롬프트를 채웁니다. 판정 모델로 사내 LLM 서빙을 고르고 저장합니다. 이어서 감시할 워크플로우의 상세 > 이용 로그 > **\[평가 기준 설정]** > \*\*\[생성]\*\*에서 그 Evaluator를 선택하고, score 이름을 `hallucination`으로, 대상 노드를 `모델 응답`으로 지정한 뒤 Sampling을 100%로 두고 저장합니다. 패널에서 활성 토글을 켜면 이후 들어오는 요청부터 채점되고, 이용 로그의 평가 기준 드롭다운에서 `hallucination`을 선택하면 `평가점수` 컬럼에 점수가 표시됩니다.

#### 정답과 대조해 정확도를 평가하려는 경우

`question` · `answer` · `source` 컬럼의 CSV를 GT 전용 전처리기로 AI 드라이브에 올리고, 워크플로우 리비전에서 그 드라이브를 GT로 연결합니다(chatflow는 `Ground Truth Retriever` 입력, agentflow는 `Use as Ground Truth` 토글). 이어서 프롬프트 예시 `Answer Correctness`로 Custom Evaluator를 만들고, 평가 기준 생성 모달의 Variable mapping에서 정답 변수를 Object Field `Output` · JsonPath `$.data.metadata.sourceDocuments`로 지정합니다. Filter에 `Metadata` 조건을 추가해 정답이 실린 요청만 대상으로 두면 정답이 없는 질문 때문에 점수가 왜곡되는 것을 막을 수 있습니다. 채점된 점수는 이용 로그의 `평가점수` 컬럼에서 확인합니다.

<figure><img src="https://541419907-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FKhN1XWFV3oOVnFMMIHTE%2Fuploads%2Fgit-blob-d5b56503f42e449f012398a716041c85d4ac4b44%2Fmetric193_16_gt-score-result.png?alt=media" alt="이용 로그 — 평가 기준을 선택하면 평가점수 컬럼에 점수가 표시됨"><figcaption><p>이용 로그 — 평가 기준을 선택하면 평가점수 컬럼에 점수가 표시됨</p></figcaption></figure>

#### 특정 조건의 요청만 골라 평가하려는 경우

평가 기준 생성 모달의 Filter에서 조건을 지정합니다. 예를 들어 특정 세션만 보려면 `Session ID` `=` 값을, 검색 단계만 보려면 대상 노드를 `문서 검색`으로 지정합니다. 조건을 입력할 때마다 아래 프리뷰의 "최근 1개월 샘플 · N건"과 샘플 목록이 갱신되므로, 저장 전에 조건이 실제로 원하는 요청을 잡는지 확인할 수 있습니다.

#### 평가 비용을 줄이고 싶은 경우

Sampling 값을 낮춥니다. 예를 들어 20%로 두면 조건에 맞는 트레이스 중 약 20%만 판정 모델을 호출합니다. 이미 쌓인 점수는 그대로 유지되고, 변경 이후 수집되는 요청부터 새 비율이 적용됩니다.

#### 평가를 잠시 멈추려는 경우

평가 기준을 삭제하지 않고 패널에서 **활성 토글을 끕니다**. 비활성 기준은 채점을 멈추지만 설정과 기존 점수는 유지되며, Evaluator 상세의 `사용 중 평가 기준` 건수에는 계속 포함됩니다. 따라서 Evaluator를 삭제하려면 비활성 기준까지 모두 삭제해야 합니다.

#### 이용 로그에 평가점수 컬럼이 보이지 않는 경우

활성 상태인 평가 기준이 하나도 없는 상태입니다. 상단에 "활성 상태인 평가 기준이 없어 평가 점수가 집계되지 않습니다." 경고가 함께 표시됩니다. \*\*\[평가 기준 설정]\*\*에서 기준을 만들고 활성화하면 컬럼이 나타납니다.

***

## 임시 코드 검수 메모: 리스크 및 보완 필요 사항

> v1.9.3 시점의 열린 항목입니다. 사용자 안내가 아니라 후속 작업 확인용입니다.

* **BE 미제공 필드 폴백 유지** — Custom Evaluator 목록·상세에서 판정 모델의 모델명·리비전명, 서빙 삭제·상태 뱃지, LLM Connection 등록 여부, 행별 수정 가능 여부는 BE 응답에 없을 때 대체 표기·전역 권한으로 폴백합니다(#18070 · #18071). 필드가 도착하면 폴백은 자동 무력화되며, 폴백 코드 제거는 BE 상시 제공 확인 후 진행합니다.
* **일부 검색·정렬 미지원** — 화면에는 기획대로 검색·정렬 옵션이 노출되지만, BE가 지원하지 않는 항목은 요청에서 생략됩니다(지원되지 않는 값 전송 시 422). BE 지원 시 매핑만 추가하면 됩니다.
* **평가점수 정렬 미제공** — 평가점수는 BE 저장 필드가 없어 정렬 컨트롤을 제공하지 않습니다(#18274).
* **Filter 조건 상한은 FE 전용 가드** — 최대 10행 제한은 프론트엔드에만 있고 BE는 행 수를 검증하지 않습니다. 상한을 올리면 프리뷰 쿼리 비용이 증가합니다(#18273).
* **`Tags` 필터 후보 값 미연동** — `filter-options`의 `tags`가 현재 빈 배열이라 필드가 노출되지 않습니다. langfuse-proxy에 프록시 엔드포인트는 추가되어 있고 admin-api 연동이 남았습니다.
* **`최근 실행` 타임존 규약 미확정** — KST 고정과 UTC + 프론트 변환 중 어느 쪽인지 계약 확인이 남아 있습니다(#18272).
* **Langfuse 활성 평가 기준 상한** — 프로젝트당 50개입니다. 상한 도달 시 처리 경로 점검이 필요합니다.
* **판정 모델과 답변 모델 동일 여부 미차단** — 기획 논의(2026-07-24)에서 순환 참조 위험이 제기됐으나, 현재 Evaluator 생성·수정 화면과 평가 기준 화면에는 동일 모델 선택에 대한 경고·저장 차단이 구현되어 있지 않습니다(관련 문구·검증 코드 없음). 운영 시 판정 모델은 답변 모델과 다른 서빙으로 지정하도록 안내가 필요합니다.
* **GT 미매칭 요청도 채점됨** — 정답(GT)이 없는 요청은 정답 변수가 빈 값으로 조합되는데도 score가 기록됩니다. 개발망 확인 시 `ground truth:` 가 비어 있는 샘플에도 1.00 · 0.95가 남아 있었습니다. 정답이 없는 요청을 제외하는 가드가 없어 현재는 Filter로 운용자가 좁혀야 합니다.
* **GT 검색 임계값 미확인** — GT 유사 질문 검색에 유사도 임계값이 적용되는지, Top K 상위 1건을 그대로 사용하는지 확인이 필요합니다. 임계값이 없으면 무관한 질문에 다른 정답이 매칭되어 평가 점수만 왜곡됩니다.
* **개발 참조 문서 갱신 필요** — `admin-front/docs/pages/agent/FE_WORKFLOW_EVAL_RULE.md`는 평가 기준 목록·CRUD·활성 토글을 "목업 유지"로 기술하고 있으나(최종 확인 2026-08-13), 현재 `ServingLog.tsx`는 `fetchEvalRules`·`fetchPanelRules`로 실 API를 호출하고 개발망에서도 실데이터가 표시됩니다. 문서 상태 표기 갱신이 필요합니다.

***

### Ground Truth 데이터 준비 가이드

평가에서 `ground_truth`(정답)를 Langfuse trace metadata에 자동 기록하려면, 워크플로우 안에 **ground truth 전용 노드**를 두고 정해진 형식으로 데이터를 준비해야 합니다. 이 섹션은 CSV 형식과 전처리기 코드 요구사항을 정리합니다.

#### 동작 원리

```
사용자 질문
  → Retriever / Agent 노드 (Is Ground Truth 활성)
  → Vector DB 검색 → 상위 1개 문서의 pageContent 파싱
  → [GT_META] 또는 [ANSWER] 태그에서 정답 추출
  → Langfuse trace.metadata.ground_truth 기록
```

`pageContent`는 Vector DB(Weaviate)의 `text` 프로퍼티와 같습니다. 전처리기가 이 `text`를 생성하므로, 전처리기 출력물에 아래 형식 중 하나가 포함되어야 합니다.

#### 지원 형식

`pageContent` 안에서 다음 순서로 탐색합니다. 첫 번째로 매칭되는 것이 `ground_truth`로 기록됩니다.

**1순위 — `[GT_META]` JSON (권장)**

```
[GT_META] {"answer": "서울은 대한민국의 수도입니다.", "source": "위키백과"}
```

* `[GT_META]` 태그 뒤에 유효한 JSON 객체가 와야 합니다.
* 중첩 JSON, 문자열 내부 `}`, 이스케이프(`\"`)를 모두 올바르게 처리합니다.
* JSON 파싱 후 compact 문자열(`JSON.stringify`)로 저장합니다.
* 파싱 실패(깨진 JSON 등)이면 `null`을 반환해 기록되지 않습니다.

**2순위 — `[ANSWER]` 평문 (폴백)**

```
[ANSWER] 서울은 대한민국의 수도입니다.
```

* `[ANSWER]` 태그 뒤 텍스트를 정답으로 사용합니다.
* 빈 줄 또는 문서 끝까지가 정답 범위입니다.
* `[GT_META]` 태그가 없을 때만 시도합니다.

#### CSV 파일 요구사항

| 컬럼                       | 필수 여부  | 설명                                                          |
| ------------------------ | ------ | ----------------------------------------------------------- |
| `question` (또는 동일 역할 컬럼) | **필수** | Vector DB 검색 쿼리. 사용자 질문과 유사도 매칭에 사용                         |
| `answer` (또는 동일 역할 컬럼)   | **필수** | 정답 텍스트. 전처리기가 `[GT_META]` 또는 `[ANSWER]` 형식으로 변환해 `text`에 포함 |
| 추가 컬럼                    | 선택     | `source`, `category` 등 메타데이터용 컬럼 허용                         |

**인코딩**: UTF-8 권장. `cp949`, `euc-kr`, `iso-8859-1`도 자동 감지합니다.

**CSV 예시 (`[ANSWER]` 형식 직접 포함)**

```csv
question,answer
서울의 인구는?,서울의 인구는 약 960만 명입니다.
대한민국의 수도는?,대한민국의 수도는 서울입니다.
```

전처리기가 `[ANSWER] {answer}` 형식으로 `text`를 구성하거나, answer 컬럼에 직접 태그를 포함할 수 있습니다.

```csv
question,answer
서울의 인구는?,"[ANSWER] 서울의 인구는 약 960만 명입니다."
대한민국의 수도는?,"[ANSWER] 대한민국의 수도는 서울입니다."
```

**CSV 예시 (`[GT_META]` JSON 형식)**

```csv
question,answer
서울의 인구는?,"[GT_META] {""answer"": ""서울의 인구는 약 960만 명입니다.""}"
대한민국의 수도는?,"[GT_META] {""answer"": ""대한민국의 수도는 서울입니다."", ""source"": ""나무위키""}"
```

> CSV에서 큰따옴표는 `""` 두 번으로 이스케이프합니다.

#### 전처리기 코드 요구사항

코드서빙으로 구동하는 커스텀 전처리기는 각 CSV 행(row)을 아래 형식의 `VectorProperties` 객체로 반환해야 합니다.

```python
{
    "text": "[ANSWER] 서울의 인구는 약 960만 명입니다.",  # pageContent로 매핑됨
    # 또는
    "text": '[GT_META] {"answer": "서울의 인구는 약 960만 명입니다."}',
    # 선택 메타데이터
    "file_name": "qa_dataset.csv",
    "source": "나무위키",  # 필요 시
}
```

**핵심 규칙:**

1. **`text` 필드에 `[GT_META]` 또는 `[ANSWER]` 포함** — 이 태그가 없으면 `parseGroundTruth`가 `null`을 반환해 ground\_truth가 기록되지 않습니다.
2. **행 1개 = 문서 1개** — 질문 하나가 검색될 때 정답 하나가 딸려오도록 행 단위로 쪼갭니다. 여러 행을 합치면 안 됩니다.
3. **question 컬럼 임베딩 대상 지정** — 사용자 질문과의 유사도 검색이 `question` 컬럼 임베딩을 기준으로 일어나도록 전처리기/AI Drive 설정에서 임베딩 대상 필드를 `question`으로 지정합니다.

**전처리기 코드 예시 (Python)**

```python
def process_row(row: dict) -> dict:
    question = row.get("question", "").strip()
    answer = row.get("answer", "").strip()
    source = row.get("source", "")

    # [GT_META] JSON 형식 권장
    import json
    gt_meta = json.dumps({"answer": answer, "source": source}, ensure_ascii=False)
    text = f"[GT_META] {gt_meta}"

    return {
        "text": text,
        "ref_text": question,   # 임베딩 대상 (AI Drive 설정에 따라 다름)
        "file_name": "qa_dataset.csv",
    }
```

#### 워크플로우 노드 설정

**Retriever 노드** — 전용 GT Retriever를 쓰는 경우:

| 항목                     | 설정값                               |
| ---------------------- | --------------------------------- |
| Is Ground Truth        | **ON**                            |
| Ground Truth Retriever | GT 데이터셋이 업서트된 VectorStore 리트리버 연결 |

**Agent 노드** — Knowledge에서 직접 활성화하는 경우:

| 항목                                                           | 설정값                                     |
| ------------------------------------------------------------ | --------------------------------------- |
| Knowledge (Document Stores) 또는 Knowledge (Vector Embeddings) | GT 데이터셋 선택 후 **Use as Ground Truth ON** |

> Ground Truth로 지정된 지식베이스는 Agent에 컨텍스트로 주입되지 않습니다. 오직 trace metadata 기록 목적으로만 검색됩니다.

#### Langfuse에서 확인

ground\_truth가 정상 기록되면 해당 trace의 **Metadata** 탭에서 확인할 수 있습니다.

```json
{
  "ground_truth": "{\"answer\": \"서울의 인구는 약 960만 명입니다.\", \"source\": \"나무위키\"}"
}
```

`[ANSWER]` 형식으로 기록된 경우:

```json
{
  "ground_truth": "서울의 인구는 약 960만 명입니다."
}
```

이 값은 Custom Evaluator의 평가 프롬프트에서 `{{metadata.ground_truth}}` 변수로 참조할 수 있습니다.

#### 트러블슈팅

| 증상                                 | 원인 및 확인 방법                                                            |
| ---------------------------------- | --------------------------------------------------------------------- |
| Langfuse trace에 `ground_truth`가 없음 | `pageContent`에 `[GT_META]` 또는 `[ANSWER]` 태그가 없음. 전처리기 출력 `text` 필드 확인 |
| `ground_truth`가 `null`로 표시됨        | `[GT_META]` 뒤의 JSON이 깨진 경우. JSON 유효성 검사 필요                            |
| 엉뚱한 정답이 기록됨                        | 유사도 검색이 잘못된 문서를 반환. `question` 컬럼 임베딩 대상 설정 및 GT 데이터셋 품질 확인           |
| Is Ground Truth를 켰는데 기록 안 됨        | Langfuse 연동(`LANGFUSE_ENABLED=true` 환경변수) 또는 traceId 전파 확인            |


---

# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.

## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.

Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:

```
GET https://genos-docs.gitbook.io/default/v1.9.3/basic-tutorials/guides/metric.md?ask=<question>&goal=<user_goal>
```

`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.

The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.

Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.